El feedback del capítulo 7 te cuenta lo que salió mal cuando un paciente ya lo vivió. Calidad y alineación es lo contrario: armás de antemano las preguntas que el agente tiene que responder bien, lo hacés responderlas y revisás qué pasó. Sirve para comprobar que un cambio de prompt, de modelo o de conocimiento no rompió lo que ya funcionaba.
Este capítulo explica las piezas, qué pasa cuando lanzás una ejecución y cómo leer los resultados. Para generar los casos con ayuda de la IA, mirá la guía Crear pruebas con Builder de calidad y alineación.
Las piezas
| Pieza | Qué es |
|---|---|
| Proyecto | La carpeta de pruebas. Pertenece al tenant, no a un agente: el mismo proyecto puede correr contra distintos agentes. |
| Caso | Un mensaje o una conversación ordenada (hasta 50 turnos), con sus criterios y, opcionalmente, una respuesta de referencia. Es un borrador: cada vez que lo guardás queda una revisión nueva. |
| Plan de pruebas | Una lista fija de revisiones exactas de casos (hasta 200). Se publica y ya no cambia: editar un caso después no altera un plan publicado. |
| Ejecución | Un plan corrido contra un agente. Cada caso se corre tantas veces como repeticiones elegiste; cada corrida es un intento. |
| Evaluador | Una instrucción para el juez de IA, versionada, con el modelo que la aplica. |
La separación entre caso y plan es lo que hace comparables dos ejecuciones: si corriste el mismo plan el lunes y el jueves, sabés que las preguntas fueron exactamente las mismas.
Qué pasa cuando lanzás una ejecución
Desde un plan publicado, Lanzar ejecución pide el agente, la cantidad de repeticiones (1 a 10), la concurrencia (1 o 2 intentos a la vez) y un tiempo máximo. Antes de lanzar tenés que marcar que autorizás las llamadas al agente y sus herramientas.
Esa casilla no es un trámite. La ejecución usa el agente real, con sus herramientas, sus integraciones y las credenciales del tenant. Si el agente de turnos de Clínica del Sol puede reservar en la agenda, un caso que pide "reservame un turno para el martes" va a intentar reservarlo. Un tenant de prueba no convierte las conexiones externas en sistemas de prueba: para probar acciones con efectos, la integración tiene que apuntar a un entorno de prueba del proveedor.
Después de lanzar:
- La plataforma verifica que el agente esté activo y sea del mismo tenant, y anota qué versión está activa en ese momento. No se elige versión: siempre se prueba la activa.
- Crea todos los intentos y los deja en cola.
- El servidor de chat los toma de a poco: como máximo 4 intentos a la vez en toda la instalación y 2 por tenant, además de la concurrencia que elegiste.
- Cada intento abre su propia sesión, con una identidad de memoria propia, y manda los turnos del caso en orden, como si fuera un usuario del widget web.
- Al terminar, la ejecución queda Completado si todos los intentos terminaron, o Completado con errores si alguno falló.
Algunas situaciones detienen un intento sin hacerlo fallar:
- Requiere intervención. El agente pidió una aprobación, una respuesta del usuario o una autorización OAuth vencida. En el agente de turnos, un caso que llega al paso Confirmar con el paciente queda ahí, porque nadie va a aprobar.
- Si la versión activa cambia durante la ejecución, el intento afectado falla: ya no se está probando lo mismo.
- Interrumpido · incierto. No se sabe si el último paso llegó a ejecutarse. No se reintenta solo: lo revisa una persona.
Cancelar ejecución detiene lo que falta, pero no deshace lo que ya pasó: un turno reservado queda reservado.
El tiempo máximo vale para toda la ejecución, no para cada caso. Cuando se cumple, los intentos pendientes quedan cancelados.
Cómo se decide si un caso cumple
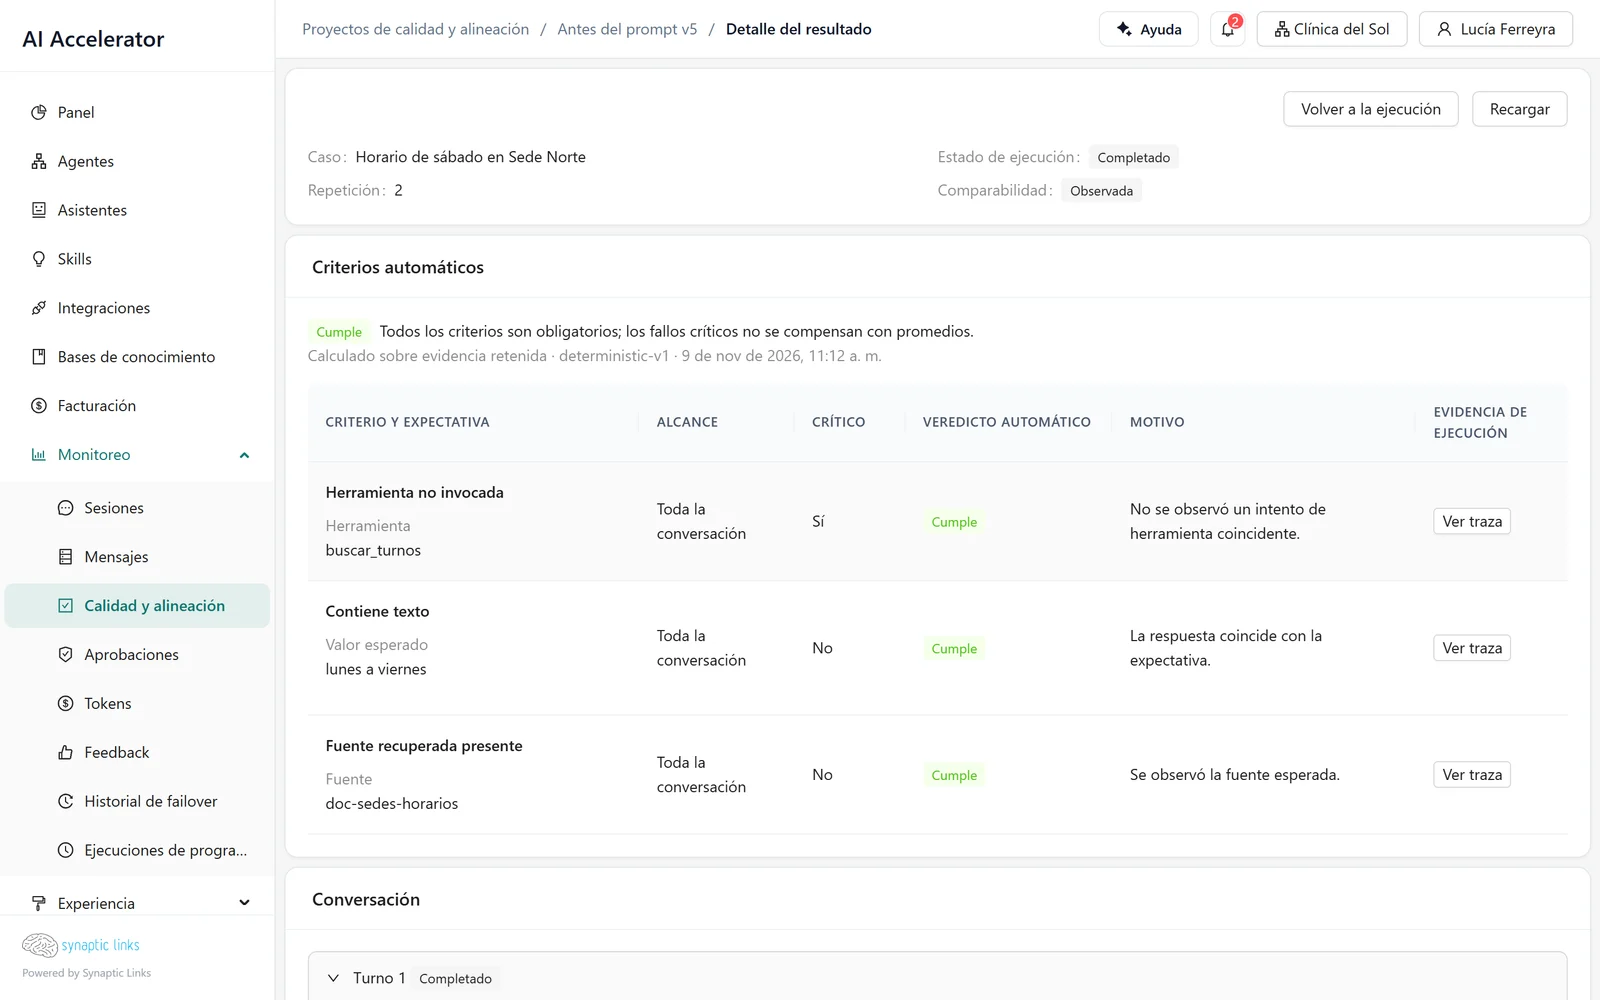
Cada caso tiene criterios automáticos. Se evalúan sobre lo que quedó registrado de la ejecución —la respuesta, las herramientas llamadas, las fuentes recuperadas—, no sobre una nueva llamada al modelo:
| Criterio | Cumple si… |
|---|---|
| Contiene texto / No contiene texto | La respuesta incluye (o no) un texto exacto, respetando mayúsculas |
| Texto exacto | La respuesta es exactamente ese texto |
| JSON igual | La respuesta es un JSON idéntico al esperado |
| Herramienta invocada / no invocada | El agente llamó (o no) a esa herramienta |
| Argumento de herramienta igual | Un argumento de la llamada tiene el valor esperado |
| Fuente recuperada presente | Esa fuente de conocimiento estuvo entre las recuperadas |
Cada criterio puede aplicarse a un turno o a toda la conversación, y puede marcarse como crítico. El resultado del caso sigue una regla simple: si un criterio no cumple, el caso No cumple; si ninguno falla pero alguno dio error, el caso queda en Error del evaluador; si no se pudo evaluar alguno, o el caso no tiene criterios, queda No evaluable. Un caso sin criterios se mide, pero nunca aprueba solo.
Para la clínica, los criterios útiles suelen ser de herramienta: "ante una consulta de horarios, no llama a la agenda", "al pedir un turno, llama a la agenda con la sede correcta". Las respuestas en lenguaje natural casi nunca se pueden comparar con un texto exacto; para eso está el juez de IA.
El juez de IA y la revisión humana
Recalificar evidencia guardada le pide a un modelo que juzgue un intento con la instrucción de un evaluador: por ejemplo, "la respuesta no da indicaciones médicas y deriva a guardia ante síntomas de urgencia". No vuelve a correr el agente: le pasa al modelo los mensajes, las respuestas guardadas y la respuesta de referencia.
- Devuelve el mismo tipo de veredicto (cumple, no cumple, no evaluable, error) con una justificación y la evidencia citada. No hay puntajes.
- Usa una conexión de modelo del propio tenant. Hoy funciona con proveedores de tipo OpenAI, y el tenant necesita tener habilitado usar sus propias claves.
- Se lanza a mano, intento por intento, y consume como cualquier mensaje.
- No cambia el veredicto automático: queda al lado.
La revisión humana funciona igual: una persona marca un intento como aprobado, rechazado o no concluyente, con un comentario obligatorio. Se suma a lo anterior sin reemplazarlo. La calibración compara juez de IA y revisión humana para saber cuánto podés confiar en el juez.
Comparar dos ejecuciones
Comparar ejecuciones pone una ejecución base al lado de una candidata del mismo proyecto. Para cada lado muestra intentos completados, veredictos, tasa de aprobación, criterios críticos que fallaron, latencia y costo. Debajo, criterio por criterio:
- Regresión: antes cumplía y ahora no.
- Mejora: antes no cumplía y ahora sí.
- Pérdida de evidencia: antes cumplía y ahora no se pudo evaluar.
- Observación faltante: el caso está en un lado y no en el otro.
Arriba indica si la comparación es compatible en condiciones observadas o exploratoria, y por qué: cambió el agente, la configuración, el plan o la versión durante la ejecución. Una comparación exploratoria sirve para mirar, pero una regresión ahí puede deberse al cambio de condiciones y no al agente.
El uso típico: publicás un plan, corrés una ejecución antes de cambiar el prompt, activás la versión nueva, corrés otra y comparás.
Quién puede hacer qué
- Cualquier rol del tenant puede ver proyectos y resultados.
- Crear casos, publicar planes, revisar y usar el juez de IA es para administradores y propietarios.
- Lanzar o cancelar una ejecución requiere además poder editar el agente.
- Archivar un proyecto o un caso es solo para el propietario.
Dónde termina
- No bloquea la activación. Una ejecución con regresiones no impide activar una versión; la decisión es tuya.
- No se conecta con el feedback. Un 👎 no se convierte en caso automáticamente: hay que escribirlo.
- Siempre prueba la versión activa. Una versión pendiente no se puede evaluar antes de activarla; para probar cambios sin afectar a los usuarios, conviene un agente de prueba separado con la misma configuración.
- Los agentes con nodos de código no se pueden evaluar, y solo se prueba el canal web.
- No hay tope de gasto por ejecución ni ejecuciones programadas: todo se lanza a mano.
- No se reintenta nada solo y cancelar no revierte efectos.
- El juez de IA solo acepta proveedores de tipo OpenAI de las conexiones del tenant.
- No registra la versión del índice de conocimiento: si reindexaste entre dos ejecuciones, la comparación no lo sabe.
Para revisar
- Las integraciones con efectos (agenda, pagos, mensajes) apuntan a un entorno de prueba antes de lanzar.
- Cada caso tiene al menos un criterio automático; los de lenguaje natural tienen un evaluador.
- Los criterios que no se pueden romper están marcados como críticos.
- Hay una ejecución base del mismo plan antes de cada cambio importante.
- Antes de activar, la comparación es compatible y no muestra regresiones críticas.