Un agente en producción se mejora mirando lo que hizo. La plataforma registra cada ejecución con un nivel de detalle que permite responder, para cualquier respuesta concreta, qué entró, qué pasos corrieron, qué modelo respondió, qué herramientas se usaron y cuánto costó. Este capítulo explica qué queda registrado, dónde verlo y cómo se usa para encontrar un problema y corregirlo.
Qué se registra de cada ejecución
Cada mensaje que procesa un agente es una ejecución. De cada una queda:
- el mensaje de entrada y la respuesta;
- cada paso del workflow, con el proveedor y el modelo que usó, la latencia, los tokens, el costo estimado, el prompt que recibió el modelo, lo que respondió y las herramientas que llamó;
- el consumo total de la ejecución;
- una línea de tiempo con la duración de cada paso.
Las ejecuciones se agrupan en sesiones (capítulo 6), y la sesión guarda además el historial completo y el resumen de memoria que usa el agente.
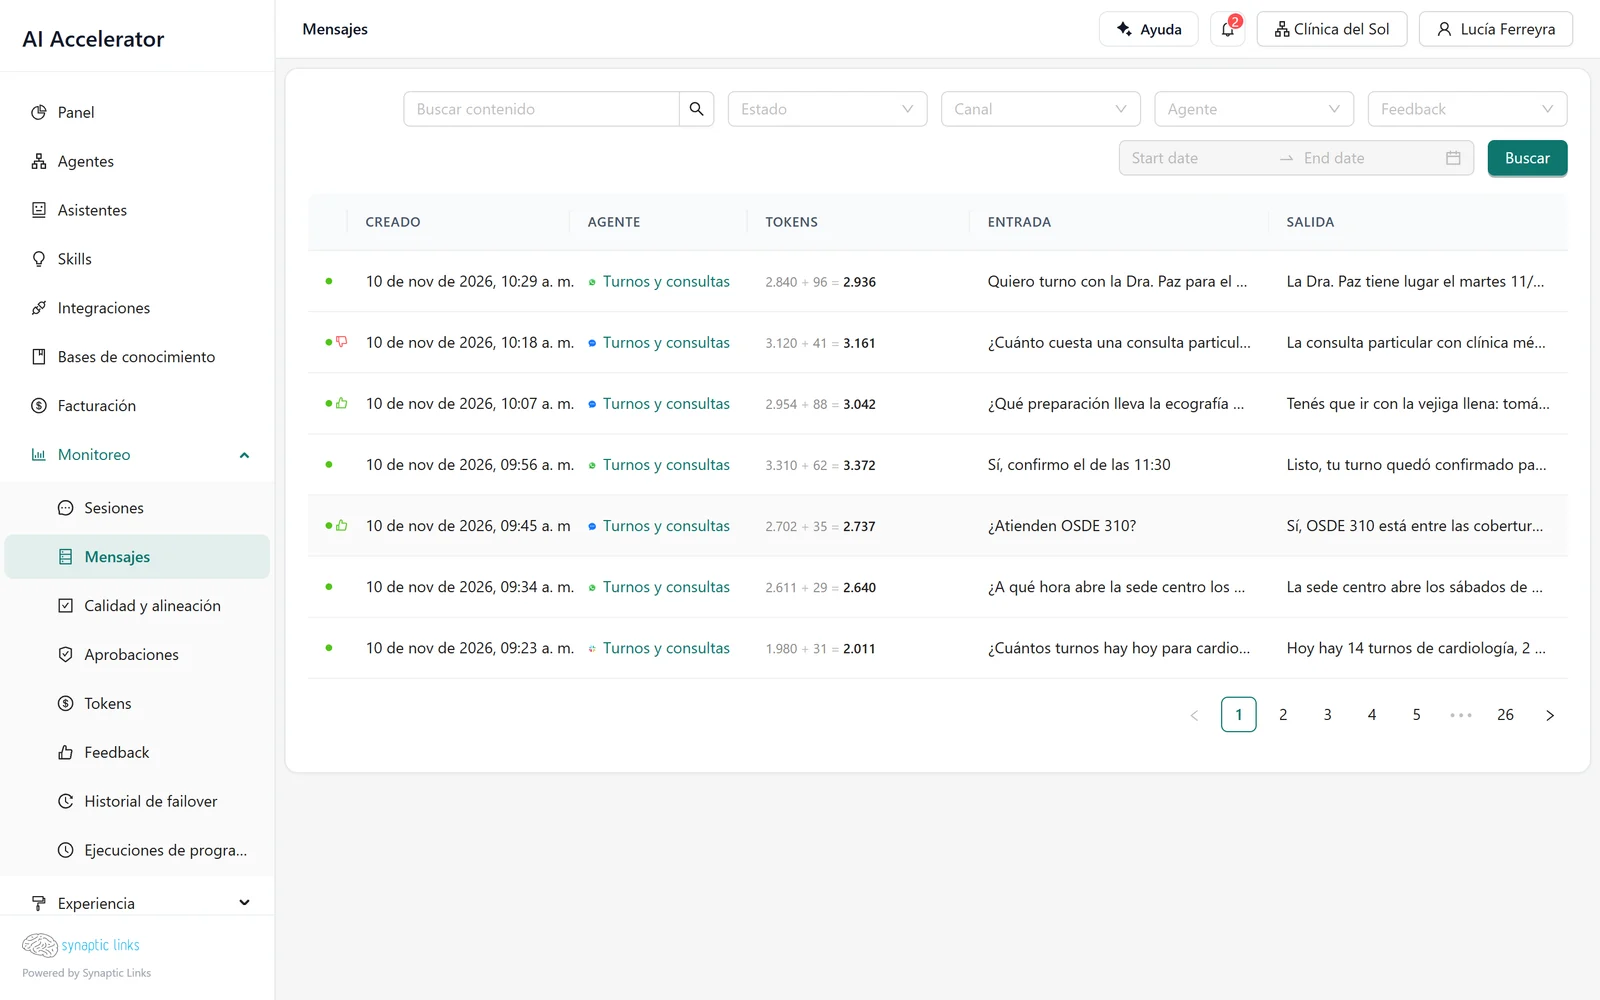
Monitoreo → Mensajes lista las ejecuciones con su estado, el agente y el canal, los tokens usados y un extracto de la entrada y la salida. Abrir una muestra el detalle paso por paso.
De un voto negativo a la causa
El feedback de los usuarios es la forma más directa de encontrar respuestas malas. Un ejemplo completo:
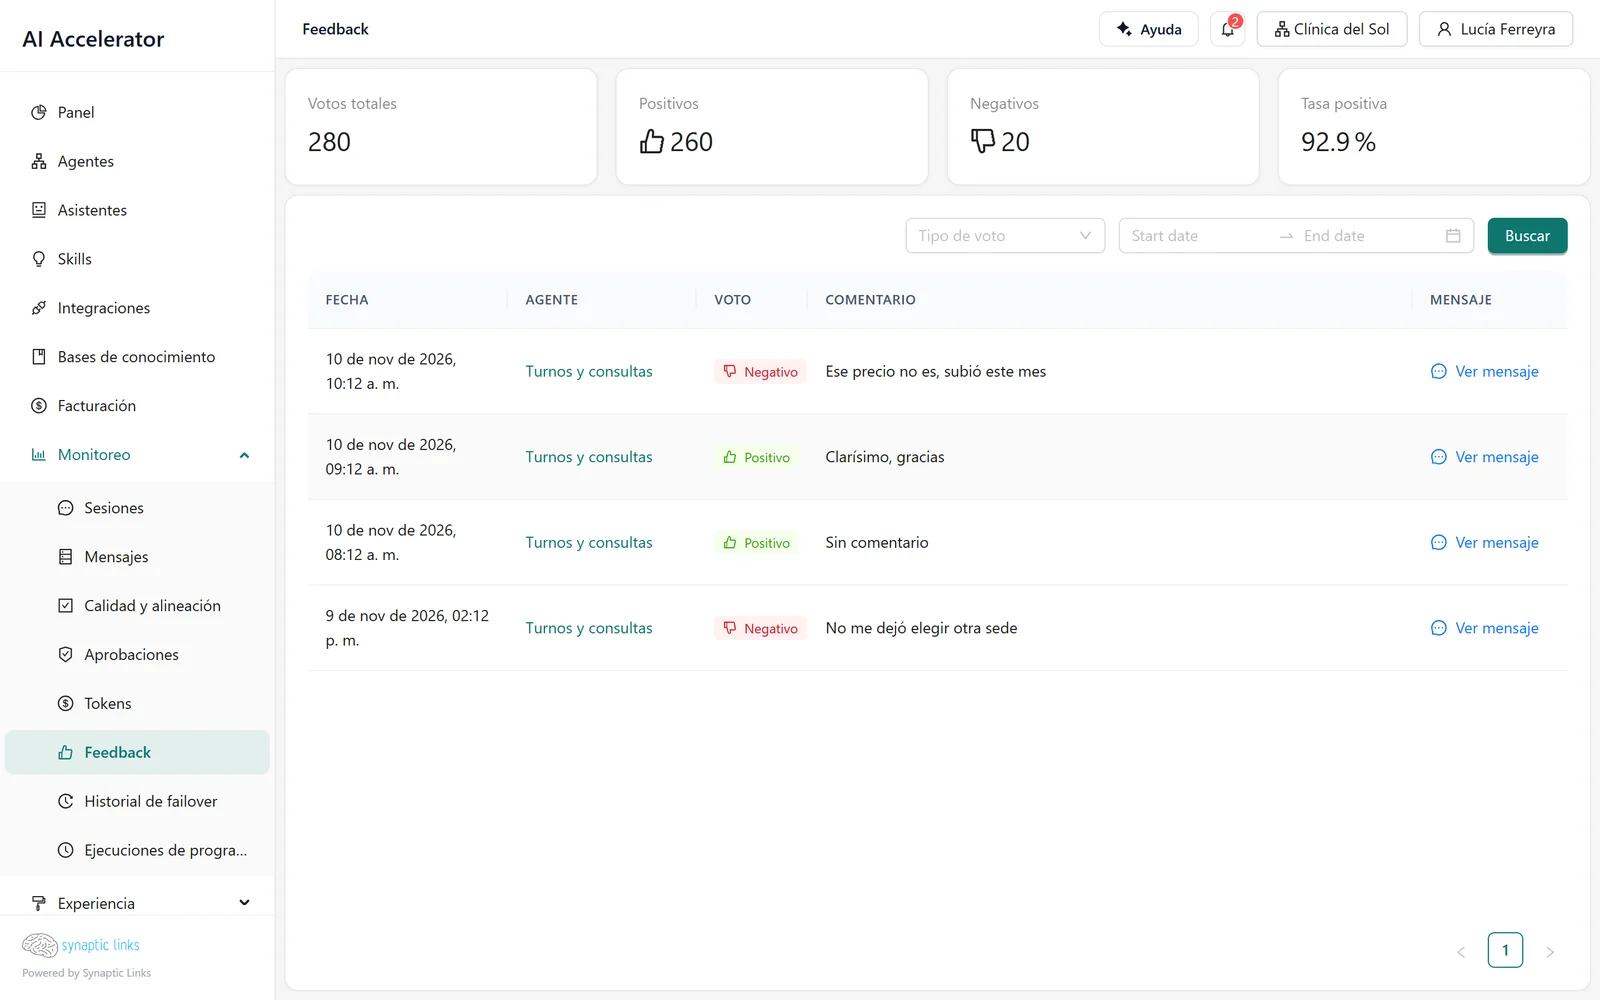
- Un paciente pregunta en el widget cuánto cuesta una consulta particular. El agente responde un precio viejo. El paciente marca la respuesta con 👎 y escribe "ese precio no es".
- La plataforma guarda el voto junto al mensaje y, como es negativo, genera un aviso de feedback negativo. Si el tenant tiene Langfuse conectado, el voto también se envía como puntuación.
- Los administradores del tenant ven el aviso en la campana de notificaciones del admin. Desde ahí se llega a Monitoreo → Feedback.
- En Feedback, la fila del voto lleva a la ejecución exacta en el historial.
- En el detalle de la ejecución se ve el paso de búsqueda: trajo un fragmento de
aranceles-2025.pdf. El documento con los aranceles nuevos no estaba en la base. - Se sube el documento nuevo, se borra el viejo y se comprueba con el probador de recuperación (capítulo 4) que ahora vuelve el fragmento correcto.
Ese recorrido —voto, ejecución, paso, causa— es el ciclo de mejora. El detalle por paso es lo que lo hace corto: sin él, "el agente respondió mal" no dice si falló la búsqueda, el modelo o una herramienta.
El voto solo está disponible en el widget web, y cada usuario solo puede votar mensajes de su propia sesión.
Salud
La plataforma revisa la configuración de cada agente y de cada tenant buscando lo que va a fallar antes de que falle:
- Crítico: un nodo apunta a una conexión de modelos, una conexión MCP o una fuente OpenAPI que ya no existe; el tenant no tiene conexiones de modelos ni herencia.
- Advertencia: un agente no tiene versión activa.
- Información: una conexión o fuente que ningún agente usa.
La sección Salud aparece en el menú solo cuando hay algo para mirar. Si la ves, abrila.
Consumo y costo
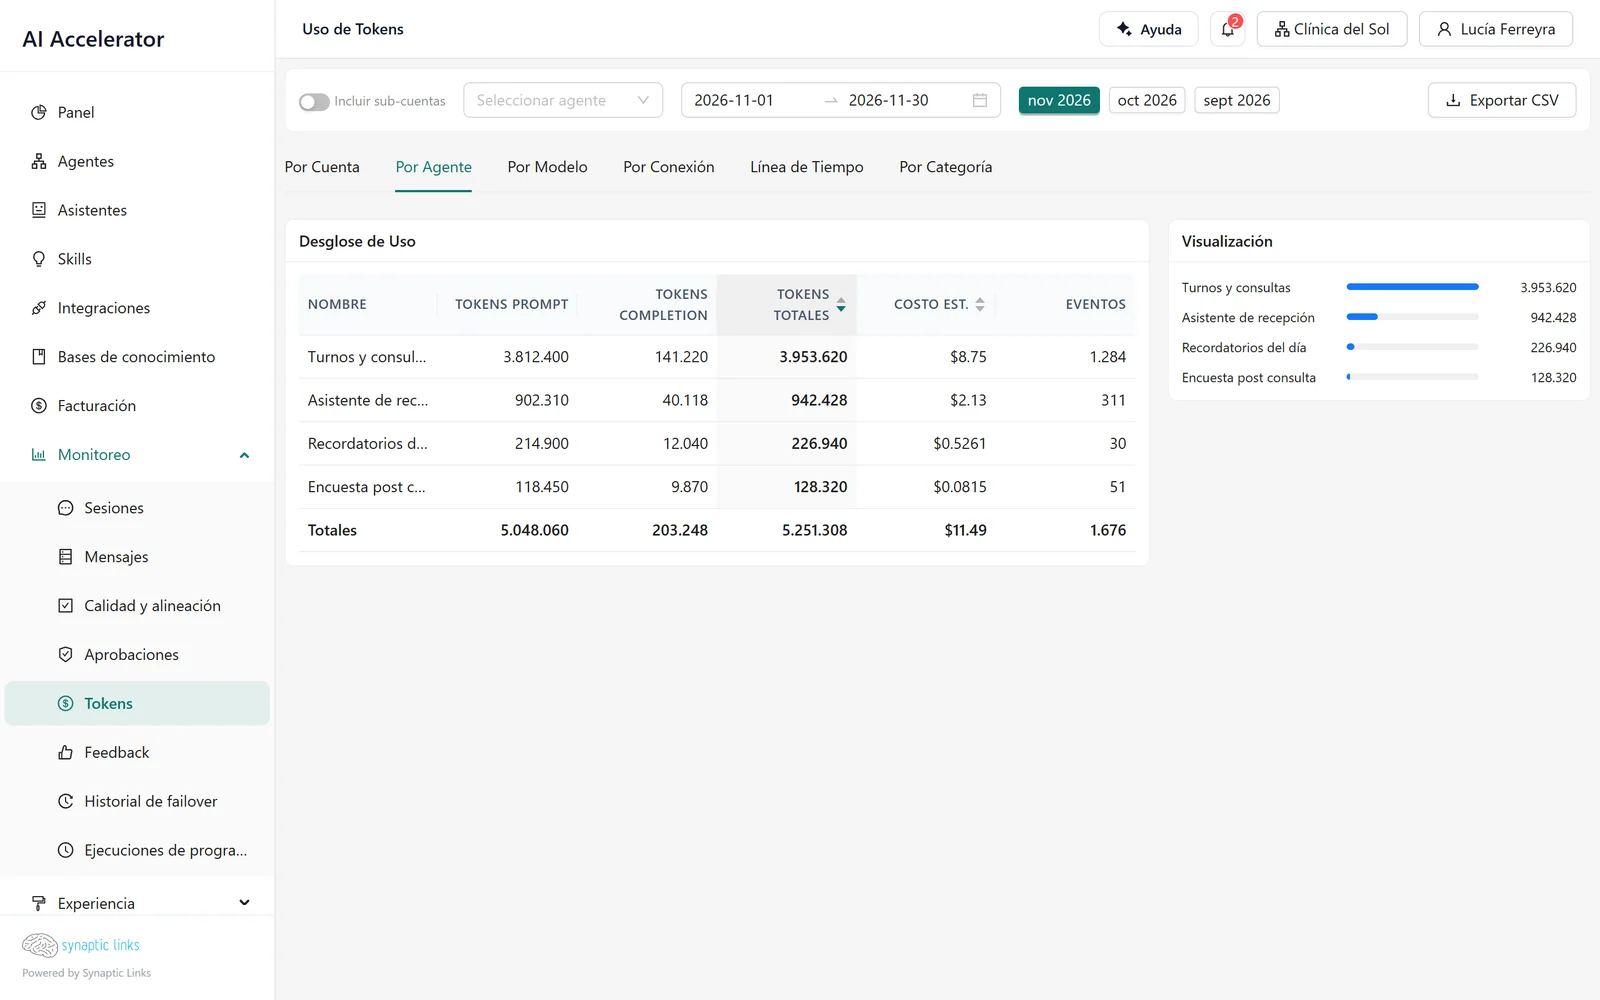
Monitoreo → Tokens agrupa el consumo por tenant, agente, modelo, conexión, día o categoría, con los tokens de entrada, de salida y el costo estimado.
El costo estimado se calcula en este orden: el precio propio que cargaste en la conexión para ese modelo, si existe; si no, una tabla de precios conocidos. Por eso cargar el precio de tu contrato en cada conexión (capítulo 2) hace que este reporte coincida con la factura del proveedor.
Lo que se le cobra a un tenant cliente se calcula aparte: con el precio propio por modelo si hay, o con el costo multiplicado por el margen configurado. Ese importe se descuenta del saldo del tenant que paga, una vez por ejecución.
Saldo, límites y cortes
Antes de cada inferencia el runtime controla, en orden:
- Los límites de consumo del mes calendario: cantidad de mensajes y gasto.
- El saldo, si el tenant es prepago: tiene que ser mayor que cero.
Si alguno no pasa, la ejecución no se hace. Cuando el saldo cruza el umbral de saldo bajo que definió el tenant, o llega a cero, se genera un aviso.
Además hay límites por minuto por tenant —chat, API y webhooks—, con valores por defecto para toda la instalación que un super admin puede ajustar por tenant (capítulo 8). La voz tiene un límite propio de la instalación, salvo que el tenant tenga valores propios: entonces usa el de webhooks. Un pedido que se pasa recibe un error de límite superado.
Avisos
Los eventos importantes —una conversación iniciada, feedback negativo, saldo bajo o agotado, un webhook desactivado— generan avisos. Cada tipo de aviso tiene una severidad y, por rol, a quién le llega y por qué medio: en la campana del admin, por correo, o por webhook saliente (capítulo 5).
- Los correos se agrupan: como máximo uno cada 15 minutos por persona, tenant y tipo de aviso. Los avisos de ese intervalo se suman al siguiente correo.
- Los miembros de un tenant padre reciben avisos de los hijos solo si eligieron incluirlos.
- Cada persona ajusta sus preferencias en Configuración → Mis avisos: por tenant, por tipo de aviso y por medio —en el admin o por correo—, con valores por defecto según su rol. El enlace de preferencias de los correos lleva a esa tarjeta.
- La campana consulta los avisos nuevos cada minuto. Marcar todo como leído está en la página de avisos.
Tu perfil
Mi perfil guarda tu nombre, tu idioma, tu contraseña —si tu forma de iniciar sesión lo permite— y los proveedores de inicio de sesión vinculados. El correo no se puede cambiar. El idioma también se cambia desde el menú de usuario, pero se guarda en el navegador, no en tu usuario: en otra computadora vuelve al idioma del navegador.
El resto de Configuración es del tenant, no personal: su resumen, el umbral de saldo bajo y los webhooks.
Probar antes de que se queje un usuario
El feedback llega después de la respuesta mala. Monitoreo → Calidad y alineación permite adelantarse: armar un catálogo de casos de prueba a partir de la configuración del agente, ejecutarlo y revisar la evidencia de cada caso. La guía Crear pruebas con Builder de calidad y alineación recorre ese armado. Crear casos no garantiza que el agente esté alineado: el resultado se revisa después de ejecutar.
Observabilidad externa
Un tenant puede conectar Langfuse desde el catálogo de integraciones. Las trazas de cada ejecución y los votos de los usuarios se envían ahí. Si un tenant no tiene Langfuse propio, se usa el del ancestro más cercano que lo tenga.
Cuánto tiempo se guarda
| Dato | Retención por defecto |
|---|---|
| Ejecuciones, mensajes, consumo y feedback | 365 días |
| Auditoría de mensajes y de herramientas | 30 días |
Borrar una sesión borra en cascada sus mensajes, su feedback, su memoria y sus registros de auditoría. Solo un propietario puede hacerlo.
Dónde termina
- El corte por saldo es "mayor que cero". El control se hace antes de la ejecución y el descuento después, así que una ejecución puede dejar el saldo apenas por debajo de cero. Hoy no hay un tope de gasto distinto de ese.
- Los límites por minuto se cuentan por instancia del runtime. Con varias instancias, el límite efectivo es mayor.
- Pasados 30 días, la auditoría de mensajes se purga: el historial sigue mostrando la ejecución, pero el detalle de la sesión puede dejar de listar sus ejecuciones.
- El reporte de tokens muestra el costo estimado del proveedor, no el importe cobrado al cliente.
- La salud revisa configuración, no disponibilidad en vivo de cada servidor MCP.
- El feedback existe solo en el widget web.
Para revisar
- Alguien del equipo es administrador del tenant y recibe los avisos de feedback negativo.
- Cada conexión tiene sus precios propios cargados, para que el costo estimado sea real.
- Los tenants prepagos tienen un umbral de saldo bajo que deja margen para recargar.
- La sección Salud no aparece en el menú: si aparece, hay algo para resolver.
- Una vez por semana, los votos negativos se revisan hasta la causa, no solo se cuentan.