Un modelo de lenguaje no recuerda nada entre una llamada y la siguiente. Todo lo que el agente "sabe" en un turno es lo que la plataforma le pone delante en ese momento: parte de la conversación, un resumen de lo anterior, algunos datos guardados sobre la persona, el contexto que manda la página donde está el widget. Este capítulo explica de dónde sale cada una de esas piezas, cuándo se pierden y qué controla cada una.
Lo que se carga antes del primer paso
Cuando llega un mensaje, antes de correr ningún nodo, la plataforma prepara:
- El dueño de la memoria. Si la persona inició sesión, es su identidad. Si no, es una identidad derivada del canal: el número de WhatsApp, el usuario de Slack, o el identificador privado del visitante del widget. Ese dueño decide qué recuerdos de largo plazo le corresponden.
- El resumen de la sesión, si existe, y los mensajes posteriores a ese resumen. Si todavía no hay resumen, todos los mensajes de la sesión.
- Los datos fijos del agente (más abajo).
- El contexto que mandó el canal: en el widget, lo que la página anfitriona adjunta a la conversación, como el paciente que está viendo su turno o la sede que eligió.
Con eso armado, corre el workflow. Los nodos deciden qué de todo eso le llega al modelo.
El nodo de contexto y la compactación
El nodo Contexto de conversación, que suele ser el primero del workflow, reúne esas piezas, las pasa por los guardrails de datos personales (capítulo 9) y las deja disponibles para los pasos siguientes.
En el camino hace algo importante: compacta. Si el resumen más los mensajes superan unos 12.000 tokens, resume los mensajes más viejos y conserva textuales los últimos ocho. Lo que nunca hace es tirar mensajes que no estén cubiertos por un resumen: si no puede resumir de forma segura, prefiere conservar todo y deja registrado que postergó la compactación. Por eso ese límite es una meta, no un tope duro.
El campo "mensajes recientes" del nodo no recorta el historial; es informativo. Lo que limita de verdad el tamaño es la compactación.
Qué ve el modelo en cada paso
Que algo esté cargado no significa que el modelo lo vea. Cada paso que llama al modelo —una tarea de modelo, un router de herramientas— tiene un selector de contexto que decide qué secciones incluir:
| Sección | Qué trae |
|---|---|
| Resumen de la conversación | Lo que pasó antes de los mensajes recientes |
| Mensajes recientes | Los mensajes no resumidos |
| Memoria de largo plazo | Los recuerdos guardados sobre esta persona |
| Contexto incluido | Lo que mandó la página o el canal |
| Mensaje del usuario | El mensaje actual |
| Instrucciones del frontend | Indicaciones que agrega la página anfitriona |
| Fecha y hora actual | Para que el modelo sepa qué día es |
Por defecto, los pasos incluyen resumen, mensajes recientes, mensaje del usuario, contexto incluido, instrucciones del frontend y fecha. La memoria de largo plazo no está en el selector por defecto: si la activás en el nodo de contexto, también tenés que agregarla al selector del paso que responde. Es la causa más común de "configuré memoria y el agente no se acuerda".
Resúmenes: memoria dentro de una sesión
El nodo Resumidor de conversación mantiene el resumen de la sesión. Se dispara cuando hay más mensajes sin resumir que el umbral (ocho por defecto), por cantidad de mensajes o por presupuesto de tokens. Resume de forma incremental: toma el resumen anterior y el tramo nuevo, y produce uno actualizado que conserva identificadores y datos concretos.
Si la llamada al modelo falla, se queda con el resumen anterior y no guarda nada, para no reemplazar un buen resumen por uno vacío.
El resumen pertenece a la sesión y a la versión del agente. Dos consecuencias:
- Una sesión nueva empieza sin resumen. Recordá que en los canales de mensajería una sesión se cierra a las 24 horas de silencio (capítulo 6).
- Si activás una versión nueva del agente, las sesiones en curso no encuentran su resumen y se recompactan desde los mensajes.
Memoria de largo plazo: lo que sobrevive a la sesión
Para que el agente de la clínica recuerde que un paciente es alérgico a la penicilina cuando vuelve tres días después, hace falta memoria de largo plazo.
Lectura, en el nodo de contexto:
- Ninguna (por defecto).
- Por persona: los recuerdos de este dueño de memoria.
- Por entidad: los recuerdos asociados a la entidad que mandó la página —un paciente, una factura, un cliente— aunque los haya generado otra persona.
Trae como máximo cinco recuerdos, ordenados por prioridad y fecha. No hay búsqueda por significado: si hay muchos, gana lo más prioritario y lo más reciente.
Escritura, con el nodo Escritor de memoria: después de la respuesta, un modelo extrae hasta tres hechos de la conversación y los guarda como registros. Hay dos modos:
- Paso manual: guarda solo lo que el modelo extrajo.
- Extracción automática: si el modelo no extrajo nada, guarda igual un registro con el intercambio, recortado.
Un hecho idéntico a uno existente actualiza el registro en vez de duplicarlo. Los recuerdos son de cada agente: el agente de turnos no ve lo que guardó el asistente de recepción. Se borran tras 365 días sin actualizarse, al borrar el agente o al borrar el tenant.
Así se ve el caso del paciente:
- Día 1, con sesión iniciada: el paciente menciona su alergia. El escritor guarda
Alérgico a la penicilinapara esa persona. - Día 4, nueva sesión, misma persona: no hay resumen ni historial de la sesión anterior, pero el nodo de contexto trae el recuerdo, y el paso que responde lo ve porque su selector incluye la memoria de largo plazo.
- El agente recuerda la alergia, pero no lo que se habló el día 1.
Si el paciente escribe desde el widget sin iniciar sesión y la página no manda un identificador privado de visitante, el dueño de memoria se deriva de la sesión, y en una sesión nueva no hay nada que recordar.
Datos estáticos: lo que el workflow sabe siempre
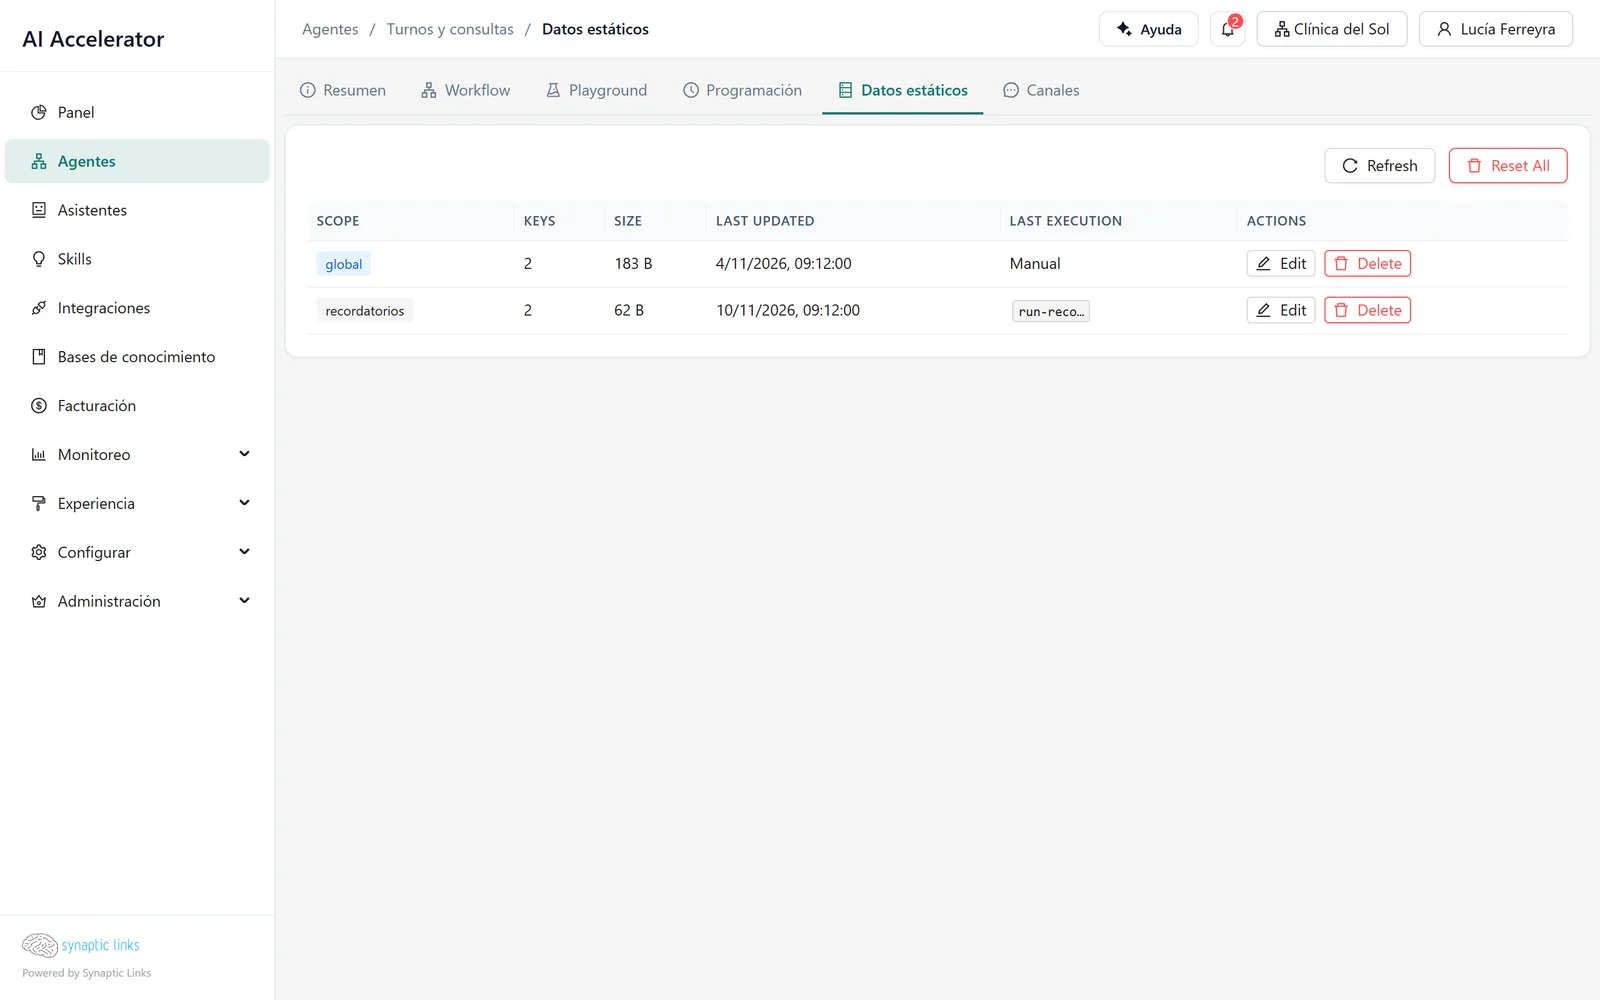
La pestaña Datos estáticos de cada agente guarda datos JSON por ámbito —por ejemplo, la lista de sedes con sus horarios, o contadores que el propio workflow actualiza—, hasta 64 KB por ámbito.
Durante una ejecución son de solo lectura para las condiciones y los nodos (state.* en las expresiones), y un nodo de código puede devolver actualizaciones, que se guardan al terminar la ejecución si no se canceló.
Lo importante: los datos estáticos no llegan solos al modelo. Para que el modelo vea las sedes, un nodo tiene que copiarlas a una variable del workflow o incluirlas en su salida.
Prompts de plataforma: el tono de las piezas internas
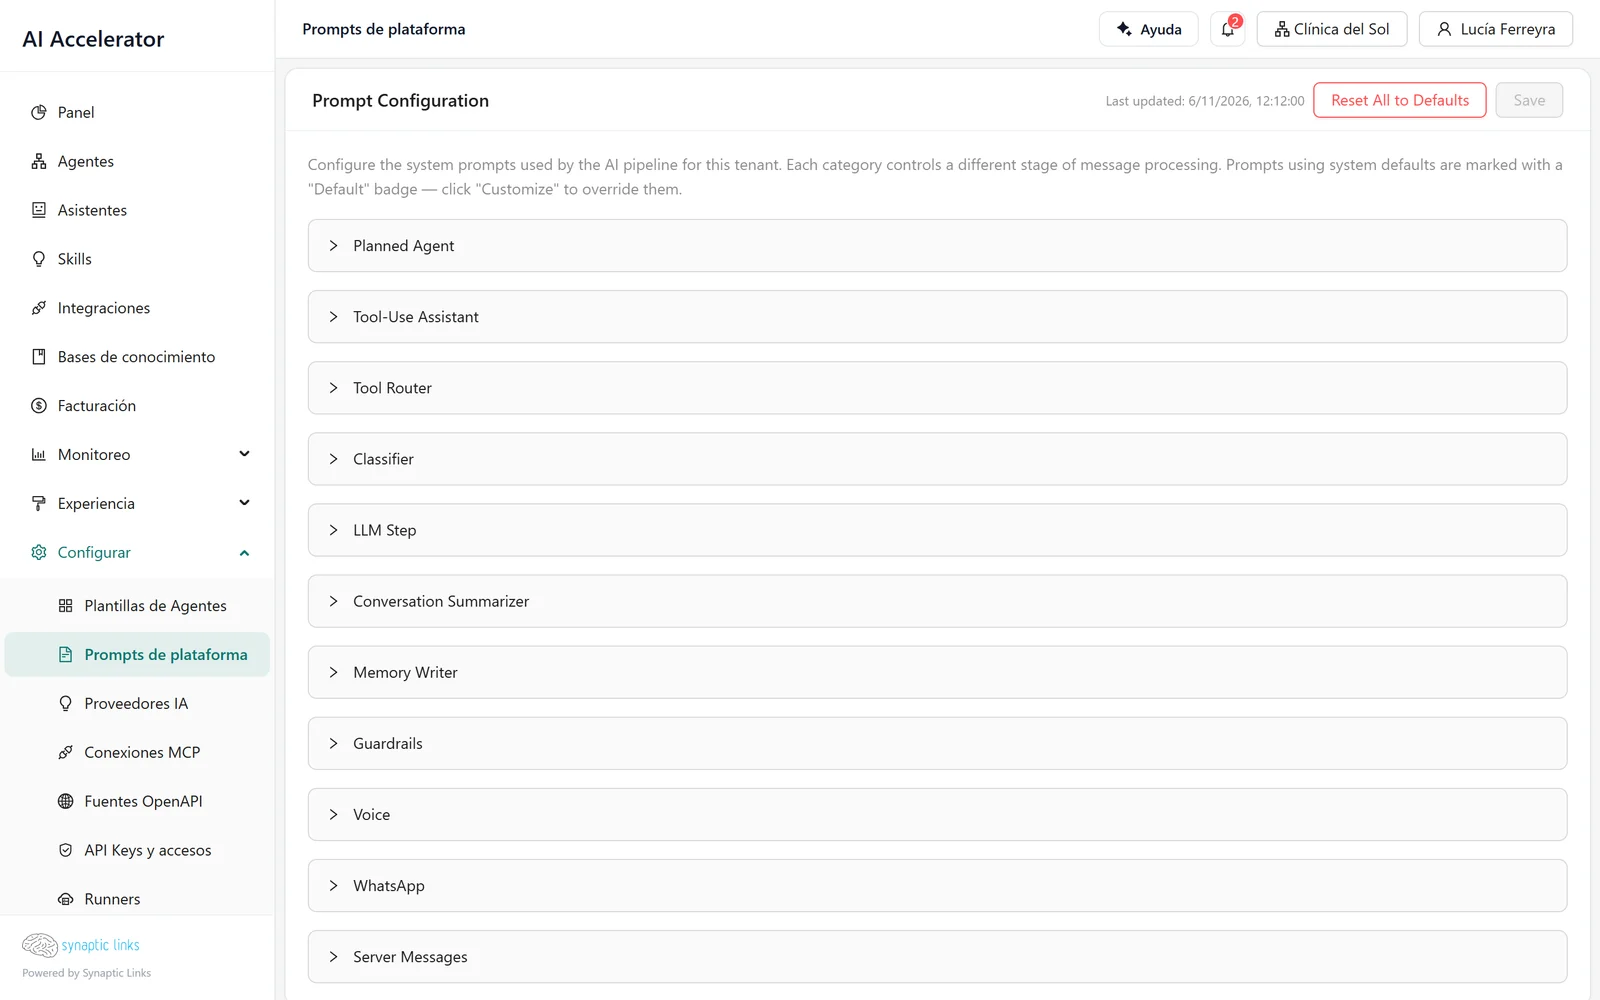
Varias piezas de la plataforma usan sus propias instrucciones: el router de herramientas, el clasificador, el resumidor, el escritor de memoria, los guardrails, los mensajes de voz y WhatsApp, los mensajes del servidor. Esas instrucciones son los prompts de plataforma, y se pueden ajustar por tenant en Configurar → Prompts de plataforma.
El orden de precedencia es: los valores de fábrica, los de la instalación, los del tenant del sistema y, por último, los del tenant. Gana el último que defina cada clave. No hay nivel por agente, salvo la plantilla propia del escritor de memoria en cada nodo.
Un caso típico: la clínica quiere que los resúmenes conserven siempre el nombre del profesional y la fecha del turno. Se agrega esa regla al prompt del resumidor en su tenant, y aplica a todos sus agentes.
Los prompts que usa el compilador de asistentes quedan fijados al compilar. Si los cambiás, los asistentes existentes necesitan recompilarse para tomarlos; la pantalla lo ofrece.
Variables y contexto de la página
Un workflow puede declarar variables. Cada una toma su valor, en orden, de lo que haya escrito un nodo Asignar estado, del contexto que mandó la página con ese nombre o de su valor por defecto. Así, la página del portal de pacientes puede mandar paciente_id y sede, y el agente los usa sin preguntarlos.
Dónde termina
- La memoria de largo plazo es por agente. No hay memoria compartida entre agentes de un tenant.
- Hay que agregarla al selector del paso que responde: el selector por defecto no la incluye.
- El resumen no sobrevive a una sesión nueva ni a una versión nueva del agente.
- La lectura de recuerdos no busca por significado: trae los más prioritarios y recientes, cinco por defecto.
- Los hechos contradictorios se acumulan: solo se unifican los idénticos.
- No hay una pantalla para ver o borrar recuerdos de una persona; se borran con el agente, con el tenant o por inactividad.
- Los datos estáticos no llegan al modelo salvo que un nodo los copie, y tienen 64 KB por ámbito.
Para revisar
- Si el agente debe recordar entre sesiones: lectura de memoria activada en el nodo de contexto, escritor de memoria en el workflow y memoria de largo plazo en el selector del paso que responde.
- Las personas se identifican: sesión iniciada, o un identificador privado de visitante en el widget.
- Los datos que el modelo necesita de los datos estáticos pasan por una variable.
- Los cambios a prompts de plataforma se probaron en el playground antes de aplicarlos a todos los agentes del tenant.
- Después de cambiar prompts del compilador, los asistentes se recompilaron.