El agente de la clínica tiene que responder cuál es el horario de la sede centro, qué obras sociales se aceptan o qué preparación lleva una ecografía. Esa información no está en el modelo: está en documentos de la clínica. Este capítulo sigue a uno de esos documentos desde que se sube hasta que el agente lo usa para responder, y explica qué decisiones tomás en el camino.
Antes de subir nada: el modelo de embeddings
Una base de conocimiento no guarda los documentos tal cual: los parte en fragmentos y guarda, para cada uno, un vector que representa su significado. Ese vector lo calcula el modelo del nivel embedding del tenant (capítulo 2). No hay valor por defecto que lo reemplace: si el tenant no tiene configurado el nivel embedding, no se puede importar, reindexar ni sincronizar y la plataforma lo dice con un error explícito.
Por eso la pantalla de la base muestra si el embedding está disponible y qué modelo se va a usar. Es lo primero que conviene mirar.
Qué pasa con un documento
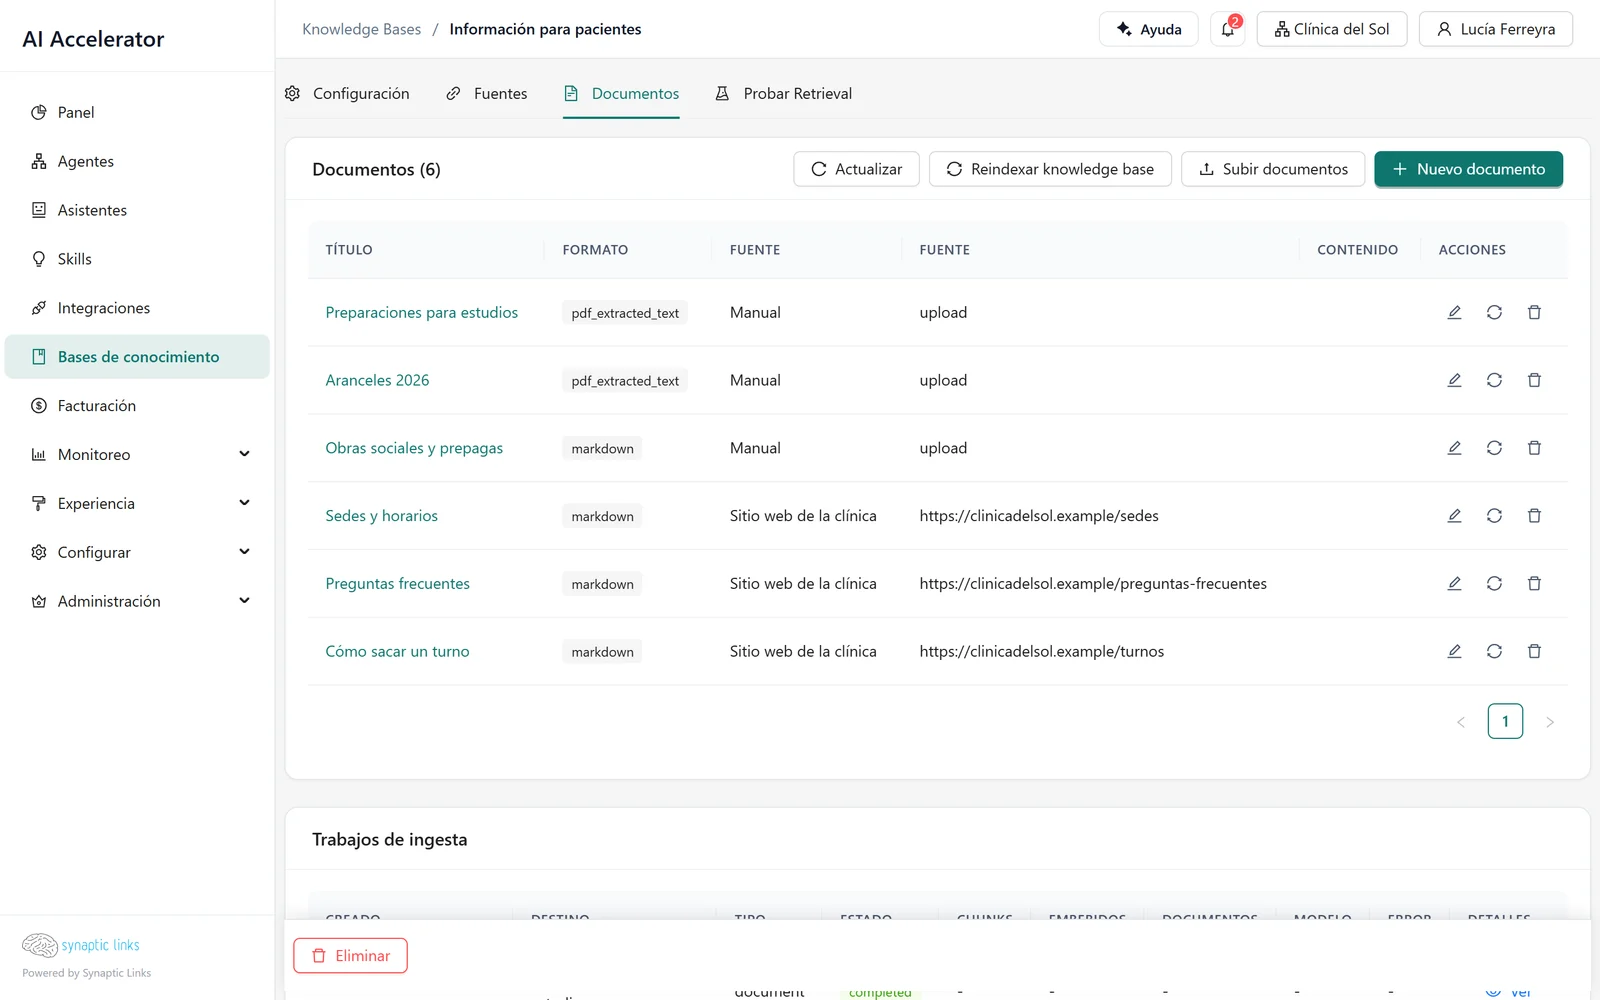
Nortelink sube preparaciones-estudios.pdf, un PDF de 12 páginas, a la base Información para pacientes.
- Validación. La plataforma verifica que el tenant tenga embeddings configurados y que el archivo entre en la cuota de almacenamiento. Acepta texto plano, Markdown, PDF, Word, CSV y HTML, hasta 20 MB por archivo y 50 archivos por envío.
- Lectura. El PDF se lee página por página. Cada fragmento que salga de una página recuerda su número de página, que después aparece como referencia.
- Fragmentación. Cada página se divide en fragmentos de unos 1.000 caracteres con 200 de solapamiento entre uno y el siguiente. El solapamiento evita que una frase quede partida justo entre dos fragmentos y no aparezca entera en ninguno.
- Vectorización. Cada fragmento pasa por el modelo de embeddings y se guarda con su vector en el almacén vectorial, etiquetado con el tenant y la base.
- Cola. Todo esto corre como un trabajo en segundo plano. La pantalla de documentos muestra el estado de cada trabajo: en cola, procesando, terminado o con error.
Elegir cómo se fragmenta
El tamaño del fragmento es una decisión con consecuencias. Fragmentos chicos encuentran respuestas puntuales con precisión, pero pierden contexto. Fragmentos grandes conservan el contexto, pero mezclan temas y diluyen la coincidencia.
Cada base tiene una estrategia de ingesta:
- Básica. Un tamaño y un solapamiento fijos para todo, configurables (el tamaño entre 100 y 10.000 caracteres).
- Adaptativa. La plataforma elige según el tipo de contenido:
| Tipo de contenido | Tamaño | Solapamiento |
|---|---|---|
| Preguntas frecuentes | 500 | 50 |
| Técnico | 1.000 | 200 |
| Narrativo | 1.500 | 300 |
| Tablas | 2.000 | 0 |
Para la clínica, que mezcla preguntas frecuentes con instructivos, la adaptativa evita tener que separar los documentos en dos bases.
Fuentes: el conocimiento que se actualiza solo
Subir archivos a mano sirve para empezar. Para información que cambia, una base puede tener fuentes que se sincronizan solas:
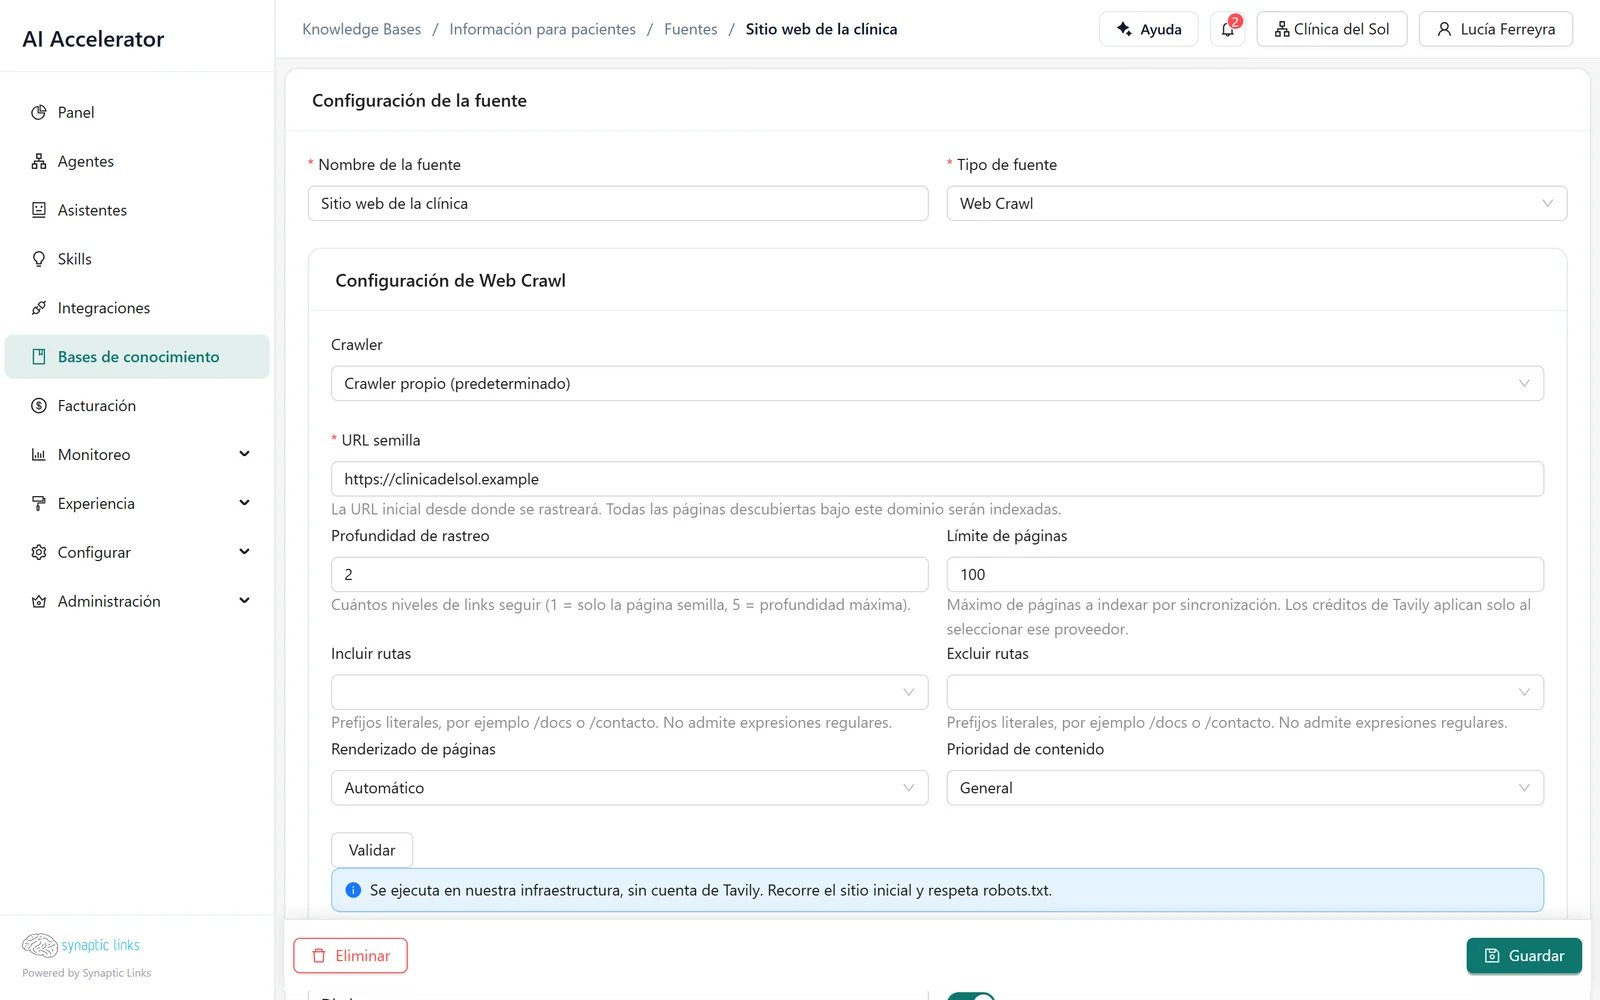
- Sitio web. Recorre un sitio a partir de una URL, hasta 5 niveles de profundidad y 500 páginas (100 por defecto), sin salir del sitio de origen.
- Confluence. Usa la integración de Confluence del tenant.
- Google Drive y Amazon S3.
Cada fuente tiene una frecuencia: manual, cada hora, cada 6 o 12 horas, diaria o semanal. En cada sincronización la plataforma compara cada documento con la versión anterior y decide si crearlo, actualizarlo o borrarlo; lo que no cambió no se vuelve a procesar. Si ya hay una sincronización en curso, no se puede lanzar otra. El historial de sincronizaciones muestra qué cambió en cada pasada.
La clínica conectó su sitio web como fuente diaria. Cuando publica un cambio de horario, al día siguiente el agente ya responde con el horario nuevo.
Cómo lo usa el agente
El conocimiento llega al agente de dos maneras.
Con un nodo de búsqueda. El nodo busca en las bases que tiene asignadas —solo en esas— y pasa los fragmentos al paso siguiente. Trae 5 resultados por defecto, como máximo 10. Tiene dos estrategias:
- Directa. Busca con el mensaje tal como llegó.
- Inteligente. Antes de buscar, un modelo reescribe la pregunta usando el resumen de la conversación y los últimos mensajes, y después elige resultados variados para no traer cinco fragmentos que dicen lo mismo.
La diferencia se ve con un ejemplo. Un paciente pregunta primero "¿qué preparación lleva la ecografía abdominal?" y después escribe "¿y la de vejiga?". Buscada tal cual, "¿y la de vejiga?" no encuentra nada útil. La estrategia inteligente la reescribe como "preparación para ecografía de vejiga" y encuentra el fragmento correcto.
También podés fijar un puntaje mínimo: los fragmentos con menos similitud que ese umbral se descartan. Con el valor por defecto, 0, no se descarta ninguno.
Como herramienta del router. Si el agente usa un router de herramientas, cada base asignada se vuelve una herramienta de búsqueda que el modelo decide cuándo usar. Cada búsqueda trae 5 resultados.
Probar antes de culpar al modelo
Cuando un agente responde mal una pregunta que "está en los documentos", casi siempre el problema es que la búsqueda no trajo el fragmento correcto, no que el modelo lo interpretó mal. El probador de recuperación permite comprobarlo sin pasar por el agente: escribís la consulta, elegís bases, estrategia y cantidad, y ves exactamente qué fragmentos vuelven, con su puntaje, el documento de origen y, si usaste la estrategia inteligente, la consulta reescrita.
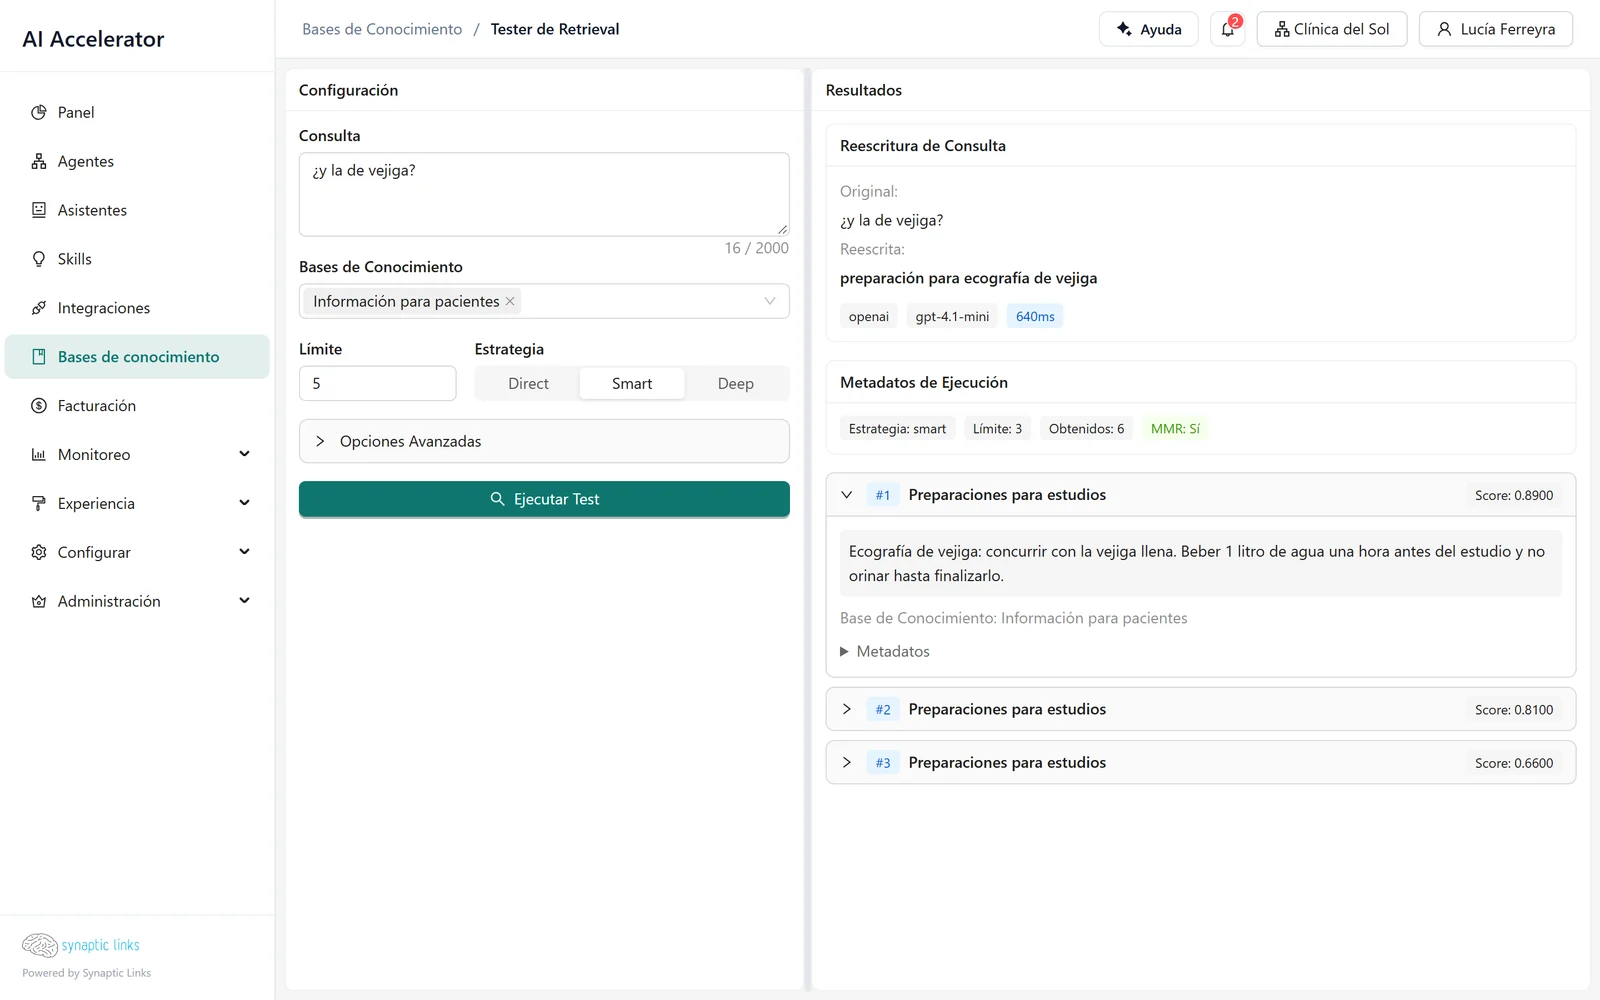
Si el fragmento correcto no aparece, el arreglo está en la base —el tamaño de fragmento, el documento, la fuente—, no en las instrucciones del agente.
Cambiar el modelo de embeddings
Los vectores de dos modelos distintos no son comparables. Si cambiás el modelo del nivel embedding, la plataforma encola la reindexación de las bases del tenant; hasta que termine, las búsquedas comparan vectores de modelos distintos y los resultados no son confiables. Conviene hacer ese cambio fuera de horario.
Dónde termina
- Hasta 10 resultados por búsqueda.
- Sin modelo de embeddings configurado, no hay ingesta. No hay modelo por defecto.
- Archivos de hasta 20 MB, 50 por envío. Los PDF escaneados sin texto no se leen: no hay reconocimiento óptico de caracteres.
- La deduplicación semántica de fragmentos casi iguales depende del almacén vectorial de la instalación y no está disponible en todos. La deduplicación de contenido idéntico al reindexar sí funciona siempre.
- Notion no está disponible como fuente.
- Una sola base no se comparte implícitamente con tenants hijos: hay que asignarla como base por defecto (capítulo 1).
Para revisar
- El tenant tiene configurado el nivel
embeddingantes de crear la primera base. - Para cada pregunta frecuente de los usuarios, el probador de recuperación trae el fragmento correcto entre los primeros resultados.
- Las bases que alimentan un nodo de búsqueda son las correctas: el nodo busca solo en las que tiene asignadas.
- Las fuentes tienen una frecuencia acorde a cuánto cambia la información, y su última sincronización no tiene error.
- Los PDF que subiste tienen texto seleccionable.