La mayor parte de lo que hace un agente en el día no es escribir. Es decidir. En qué categoría cae este mensaje. Si está dentro del alcance del negocio. Cuál de estas cuarenta tools vale la pena ofrecerle al modelo en este turno.
Todas esas preguntas se resolvieron siempre con la misma máquina que escribe las respuestas: armar un prompt, llamar a un modelo de chat, parsear la palabra que vuelve y esperar que sea una de las que ofreciste. Funciona, casi siempre. También es lento para lo que es, de vez en cuando devuelve algo que ni siquiera es una categoría, y la única idea de qué tan seguro estaba es lo que se le ocurrió decir.
En septiembre de 2026 TypeSafe AI lanzó Jev, el primero de lo que llama modelos System One. No genera texto. Le das un estado y una pregunta tipada, y contesta con el valor, una probabilidad para cada opción y una confianza derivada de esa distribución. El proveedor publica un precio de entrada de USD 0,042 por millón de tokens, no cobra la salida y declara respuestas de punta a punta de 70 a 500 milisegundos.
Un modelo así vale lo que vale lo que la plataforma hace con sus respuestas. Esta nota explica cómo AI Agent Builder trata una decisión de manera distinta a una generación: dónde vive el modelo de decisión, qué pasa el día que no está disponible, qué hace cada tipo de paso con una respuesta de la que no está seguro y qué guarda cada corrida.
Qué contesta Jev, y qué no
Tres formas de pregunta cubren todo lo que hace Jev:
- Sí o no, con una probabilidad.
- Una elección entre hasta 255 opciones con nombre, cada una con su propio criterio.
- Un puntaje sobre una escala ordenada de niveles.
Todas las preguntas de un request se evalúan juntas, en un solo viaje de ida y vuelta: seis preguntas de sí o no cuestan más o menos la misma espera que una.
Dos propiedades lo hacen mejor que un modelo de chat para rutear:
No puede contestar con una opción que no ofreciste. No hay texto que parsear ni variantes mal escritas que contemplar. El valor que vuelve es uno de los tuyos, o la llamada falló.
La incertidumbre es un número sobre el que se puede actuar. Cuando un mensaje razonablemente puede ser dos cosas, no recibís una apuesta dicha con seguridad. Recibís 0,48 contra 0,28 y una confianza baja, y la plataforma puede tratar eso como la señal que es.
El proveedor es igual de preciso sobre los límites, y conviene tomarlos al pie de la letra: no cuenta, no hace cuentas, no compara fechas, no extrae valores ni señala posiciones de caracteres, y lee el contenido de forma literal, así que un texto escrito para torcer la respuesta la puede mover. Por eso nunca es la única línea de defensa ante nada adversarial, y por eso la detección de PII sigue en herramientas que devuelven posiciones.
Una decisión es otro tipo de modelo
La primera decisión de diseño es dónde vive el modelo de decisión. AI Agent Builder le da un slot propio en los modelos por defecto del workspace, al lado de los que ya existen para embeddings, voz y generación de imágenes, y al lado de los tres niveles de chat —Low, Normal y High— que dicen cuánto modelo merece un paso.
Esa separación hace tres cosas.
Un paso pide "el modelo de decisión", nunca un proveedor. El classifier no sabe que está hablando con Jev. Si el año que viene sale un segundo modelo System One, o el mismo se sirve detrás de un gateway, el workspace cambia una configuración y todos los pasos la siguen. La plataforma distingue los dos tipos de modelo por lo que el modelo sabe hacer, no por quién lo vende.
Un paso que escribe no lo puede elegir. Solo los pasos cuya salida entera es una decisión aceptan el nivel Decision: un classifier, un chequeo de alcance del negocio, la preselección de un tool router. Una tarea de IA o una respuesta nunca lo ven como opción, porque un modelo que no escribe sería la elección equivocada ahí por construcción, y el error queda descartado donde se define el paso, no librado a quien lo configura.
Es una sola configuración para todos los agentes de abajo. El slot pertenece al workspace, así que cambiar el modelo una vez mueve todos los classifiers de todos los agentes. Si operás agentes para clientes, sus workspaces heredan la conexión del tuyo sin poder leer nunca la key, y un cliente que necesita su propia cuota trae la suya.
Y cuando el slot está vacío, no cambia nada. Un paso al que se le pide decidir sin modelo de decisión configurado hace exactamente lo que hacía antes de que el slot existiera: un modelo de chat, un prompt, una respuesta parseada. Así salió la capacidad sin alterar un solo agente existente.
El fallback es uno que nombraste vos
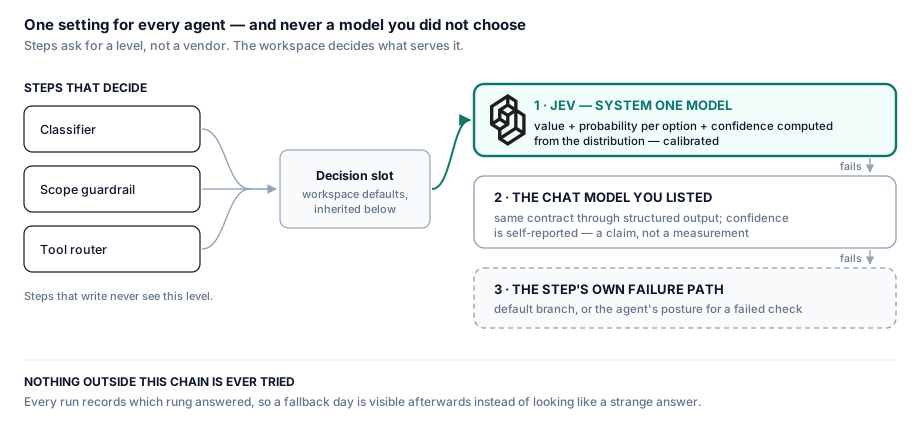
Un modelo de decisión está delante de cada turno, y eso hace que su caída sea la caída de todos. Por eso el slot recibe una cadena, no un modelo solo: un primario y los candidatos que lo siguen, en el orden en que los listás.
La cadena puede salir de la familia. Un fallback puede ser un modelo de chat común —uno chico y barato es la elección sensata— que contesta la misma pregunta tipada mediante salida estructurada. Una cadena cuyos fallbacks solo pudieran ser otros modelos System One pondría la página de estado de un único proveedor entre vos y cada classifier que corrés.
| Situación | Qué hace el paso |
|---|---|
| No hay modelo de decisión configurado | Exactamente lo que hacía antes: un modelo de chat, un prompt, una respuesta parseada |
| Falla el primario | Contesta el siguiente candidato que listaste vos |
| Fallan todos los candidatos | Decide el camino de falla del propio paso |
Nunca se prueba nada fuera de la cadena que configuraste. Un modelo que no elegiste nunca se sustituye en silencio el día que tu primario está caído: es la misma regla que gobierna el failover de cualquier otro modelo de la plataforma.
Cada intento pasa por el mismo wrapper que el tráfico de chat, así que una conexión de decisión que falla cuenta contra su salud como cualquier otra. Después de suficientes fallas se abre su circuito, y en el turno siguiente la cadena arranca por el candidato que sigue contestando en lugar de esperar al que no.
El fallback es un fallback, no un par, y la diferencia es la confianza. Un modelo System One la calcula a partir de la forma de una distribución. A un modelo de chat se le pregunta qué tan seguro está y contesta en el mismo movimiento que la decisión. Los dos números se ven idénticos en un reporte y significan cosas distintas, y por eso cada respuesta registra qué tipo de modelo la produjo.
Qué hace cada paso cuando el modelo duda
Una confianza no vale nada si quien la recibe la ignora. Cada uno de los tres pasos que usan el modelo de decisión hace una pregunta de forma distinta, y cada uno tiene su propia regla para la respuesta dudosa, elegida según lo que cuesta equivocarse en ese lugar.
| Paso | Qué pregunta | Cuando el modelo duda |
|---|---|---|
| Classifier | Una elección entre tus categorías | Debajo de 0,5, la rama por defecto |
| Chequeo de alcance | Un sí o no: ¿está en alcance? | Se inclina a "en alcance"; bloquea solo ante un no claro |
| Tool router | Un sí o no por tool, todo en una llamada | Piso bajo; ante cualquier falla, el catálogo entero |
Classifier: fallar hacia la cautela
Tus categorías se convierten en las opciones, y los ejemplos de cada categoría en su criterio: el texto contra el que decide el modelo. Una categoría vaga es la razón más común por la que un classifier rinde menos de lo esperado, y por eso vale la pena escribir ese texto como una definición y no como una etiqueta.
El classifier se niega a rutear sobre una apuesta. Debajo de una confianza de 0,5 toma la rama por defecto, exactamente como si la respuesta hubiera sido ilegible. Eso sigue la propia guía del proveedor —debajo de la mitad, derivar a una persona— y significa que un classifier sobre Jev falla hacia la cautela y no hacia un error dicho con seguridad.
Cuando falla la cadena entera, el paso no reintenta la pregunta en silencio contra un modelo de chat. Eso contestaría con una decisión que nadie configuró y escondería una integración rota detrás de una conversación que funciona. La falla cae en el mismo camino de "sin coincidencia", y la corrida lleva el mensaje de error, así que quien la lee no necesita los logs del servidor para saber qué pasó.
Chequeo de alcance: el beneficio de la duda es para el usuario
El chequeo de alcance se convierte en una sola pregunta de sí o no. La descripción del negocio y los ejemplos permitidos definen el "sí", los ejemplos bloqueados definen el "no", y el mensaje del usuario viaja en su propio campo, no pegado dentro de las instrucciones: es un dato que el modelo lee, no un texto indistinguible de la pregunta misma.
Los costos de sus dos errores no son simétricos. Bloquear por error a un cliente es peor que dejar pasar una pregunta fuera de tema a un modelo que de todos modos la va a rechazar. Por eso un mensaje pasa salvo que la probabilidad de "en alcance" caiga debajo de 0,35, y debajo de 0,15 la violación se reporta con severidad alta. Si el chequeo mismo falla, la postura configurada del guardrail para un chequeo fallido decide si la puerta se abre o se cierra; la falla nunca se traga.
Va al lado de los chequeos deterministas, nunca en su lugar. Un mensaje escrito para convencer al chequeo de que diga "sí" lo puede mover; el chequeo de alcance acota lo que llega al agente, no es lo que se interpone entre un atacante y tus datos.
Tool router: una preselección, no una decisión
Un router con decenas de tools no debería ofrecerle todas al modelo en cada turno. Antes de que arranque el loop del agente, el modelo de decisión recibe una pregunta de sí o no por tool —¿esta tool ayudaría a contestar este mensaje?— con la propia descripción de cada tool como criterio, y las contesta todas en una sola llamada.
El router se queda con las tools que superan un piso de 0,15, hasta el límite del nodo, más las que el operador fijó. El piso es bajo a propósito: es una lista de candidatas, no una decisión de llamar a nada. El agente sigue eligiendo, y dejar afuera la tool que el usuario necesitaba cuesta el turno entero, mientras que incluir una marginal cuesta unos pocos tokens.
Por eso todas las fallas se inclinan hacia el mismo lado. Por encima de cien tools, una pregunta por tool deja de ser la llamada barata que se supone que es, y el router ofrece el catálogo entero. Si la preselección no se puede armar, ofrece el catálogo entero. Sin modelo de decisión configurado, las mismas preguntas van al modelo de chat del propio nodo bajo el mismo contrato, con una confianza declarada en lugar de calculada.
Donde un selector de chat dice "estas dos", este te dice qué tan cerca quedó la tercera.
Qué guarda la corrida
Cada decisión queda registrada en el paso que la tomó: el modelo que la sirvió, qué escalón de la cadena contestó y por qué conexión, su latencia y sus tokens, la confianza, la probabilidad de cada opción y si quedó debajo del piso. Una decisión se mide como cualquier llamada a un modelo, porque una decisión que no se mide es una que no se le factura a nadie y que nadie puede presupuestar.
Ese registro es la herramienta de ajuste. Una categoría que aparece una y otra vez como segunda opción con 0,4 se está superponiendo con otra, y el arreglo es una oración más precisa en su criterio, no un modelo más grande. Una corrida servida por el fallback se ve como tal, en lugar de parecer una respuesta rara del primario.
Qué cambia en el costo
Una decisión se cobra solo por la entrada. A la tarifa publicada del proveedor, una decisión cuyo estado y pregunta suman 2.000 tokens cuesta unos USD 0,000084, y cien mil de ellas, unos ocho dólares con cuarenta.
La comparación que vale la pena no es el titular del proveedor. Sus cifras de lanzamiento —dos órdenes de magnitud más rápido y más barato— están medidas contra modelos de frontera. Nadie rutea con un modelo de frontera. Contra un modelo de chat chico, a USD 0,20 por millón de tokens de entrada y USD 1,20 por millón de salida (la tarifa publicada de OpenAI para GPT-5.6 Luna, su modelo para alto volumen, al 28 de septiembre de 2026), la misma decisión cuesta unas cinco veces más, y suele tardar más de un segundo en lugar de una fracción.
Cinco veces sigue siendo la diferencia entre una línea del presupuesto y un error de redondeo. Pero son cinco, no cuatrocientas, y conviene saber contra qué número estás presupuestando. La ganancia más grande muchas veces es la latencia: un classifier y un chequeo de alcance delante de cada turno son espera que el usuario siente.
Dónde se detiene
- Hoy lo usan tres pasos: el classifier, el chequeo de alcance del negocio y la preselección del tool router. Todo lo que tenga que producir texto sigue en un modelo de chat, por diseño.
- La distribución completa todavía no está en la pantalla de la corrida. La vista de la corrida muestra el modelo, la latencia, los tokens y la opción elegida; las probabilidades por opción y la confianza están en el registro de la corrida y se leen con las herramientas de auditoría de corridas de la plataforma.
- Por encima de cien tools no hay preselección; el router ofrece todo, como antes.
- El chequeo de alcance no es una frontera de seguridad. Lee el contenido de forma literal, y el contenido se puede escribir para moverlo.
- La confianza de un fallback no es la del primario. Queda registrada como proveniente de un modelo de chat, y así hay que leerla.
Seis invariantes para verificar en cualquier sistema
Sea lo que sea que rutee las decisiones de tus agentes —esta plataforma u otra—, estas son las propiedades que vale la pena exigir, y cada una se puede probar en una tarde.
- La respuesta siempre es una de las opciones ofrecidas, o la llamada falló. Pasale un mensaje que no encaje en ninguna y mirá qué vuelve.
- Nunca contesta nada fuera de la cadena configurada. Bajá el primario y fijate qué modelo sirvió la decisión siguiente. Sin nada configurado, el comportamiento tiene que ser exactamente el de antes.
- Cada respuesta dudosa tiene un destino con nombre, paso por paso. Para cada classifier, decí adónde va a parar un mensaje con 0,4 de confianza. Si la respuesta es "a algún lado donde se pierde en silencio", ese es el bug.
- Una cadena que falla llega al camino de falla del paso. No se reintenta en un modelo que nadie eligió, y no se traga en un valor por defecto que parece una respuesta.
- Cada decisión registra qué modelo y qué escalón contestó, y su confianza va etiquetada con el tipo de modelo que la produjo.
- El texto del usuario viaja como dato, en su propio campo. Leé el request que manda de verdad una decisión y comprobá que el mensaje no esté pegado dentro de las instrucciones.