Un agente cambia cada vez que alguien edita sus instrucciones, le cambia el modelo o resincroniza su base de conocimiento. Cada cambio queda en vivo en minutos y ninguno pasa por un proceso de release. Sin pruebas atadas a versiones, después nadie puede decir si el agente mejoró, empeoró o simplemente cambió.
Cerrar esa brecha lleva cinco pasos: escribir las pruebas, congelarlas, ejecutarlas contra el agente real, juzgar los resultados y comparar versiones. Cada paso tiene investigación detrás, y cada uno deja de hacerse en cuanto depende de que alguien se acuerde de hacerlo a mano.
Qué tiene que hacer un proceso de pruebas para agentes
El vocabulario sale del texto de ingeniería de Anthropic Demystifying evals for AI agents (9 de enero de 2026): una tarea (task) es una prueba con criterios de éxito definidos, un trial es un intento de esa tarea, un grader puntúa algún aspecto del resultado, y un transcript es el registro completo de un trial. De la investigación y los estándares salen seis requisitos.
1. Partir de lo que realmente falla, y leerlo. En su FAQ AI Evals: Everything You Need to Know (18 de septiembre de 2026), Hamel Husain y Shreya Shankar recomiendan empezar con unas 100 trazas diversas, con un experto del dominio como quien decide la calidad. La versión de Anthropic: entre 20 y 50 tareas simples sacadas de fallas reales son un buen comienzo. Una suite vale lo que valen las fallas de las que salió.
2. Ejecutar cada caso más de una vez. Un solo acierto prueba poco en un sistema que responde distinto cada vez. Los autores de τ-bench, Shunyu Yao y colegas, introdujeron una métrica llamada pass^k para medir la confiabilidad del comportamiento de un agente a lo largo de varios trials, y reportaron que incluso agentes de function calling de última generación como gpt-4o resolvían menos de la mitad de las tareas y, en el dominio retail, menos del 25 por ciento cuando tenían que acertar los ocho trials. Anthropic da la cuenta: un agente que acierta el 75 por ciento de las veces por trial pasa tres trials seguidos cerca del 42 por ciento de las veces.
3. Esperar que los criterios se muevan. En Who Validates the Validators? (Shankar y colegas, 2024), un estudio sobre personas que escriben evaluaciones de salidas de modelos, los autores nombran un fenómeno al que llaman criteria drift: se necesitan criterios para calificar las salidas, pero calificarlas es la manera de descubrir los criterios. Una suite de pruebas se revisa con el tiempo, y por eso un resultado solo significa algo si podés decir exactamente qué revisión lo produjo.
4. Calibrar al juez. Cuando un modelo califica respuestas de texto libre, trae sus propios sesgos. El paper de MT-Bench (Zheng y colegas, NeurIPS 2023) encontró que un juez fuerte puede llegar a más del 80 por ciento de acuerdo con las preferencias humanas, el mismo nivel que alcanzan los humanos entre sí, y documentó además sesgos de posición, verbosidad y autopreferencia (self-enhancement). La guía de Anthropic es calibrar de cerca a los graders basados en modelos contra expertos humanos; la de Husain y Shankar, medir las tasas de verdaderos positivos y verdaderos negativos de un juez contra etiquetas humanas antes de confiar en él.
5. No dejar que quien escribe las pruebas las afloje. La forma obvia de conseguir una suite es pedirle a un agente que la escriba. El riesgo es que un agente que optimiza por un resultado en verde reescriba los criterios en vez de mejorar el sistema. El benchmark EvilGenie (Gabor, Lynch y Rosenfeld) probó tres agentes de código y reporta reward hacking explícito en dos de ellos, Codex de OpenAI y Claude Code de Anthropic. Lo que escriba los casos no debe poder, además, ejecutarlos, calificarlos ni mover la vara.
6. Conservar el registro. El AI Risk Management Framework del NIST pide que los conjuntos de prueba, las métricas y las herramientas usadas para probar estén documentados (subcategoría MEASURE 2.1), y que el desempeño se mida y se demuestre en condiciones similares a las del despliegue, con las mediciones documentadas (MEASURE 2.3). Para los sistemas clasificados como de alto riesgo, el artículo 12 del AI Act de la UE exige el registro automático de eventos durante la vida del sistema, con un nivel que permita trazabilidad. En la práctica, cuando un auditor pregunta por qué la versión 14 de un agente salió a producción, necesitás las pruebas, la evidencia, el juez y la persona que decidió.
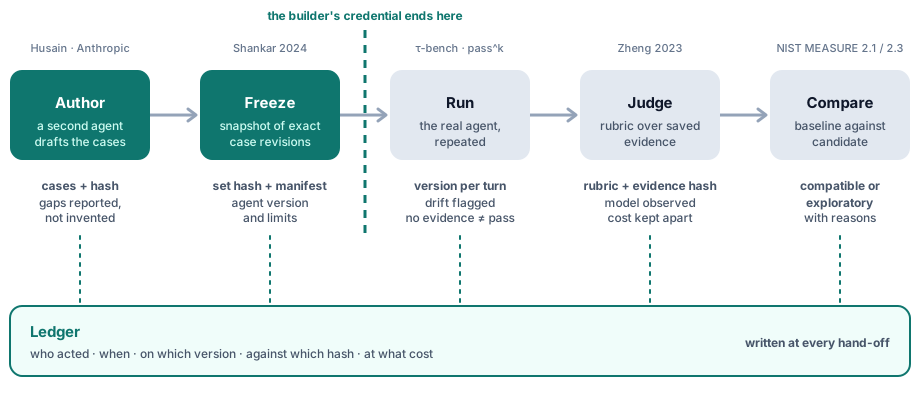
Redacción: un segundo agente escribe el primer borrador
Escribir cincuenta buenos casos a mano es la razón por la que casi ningún agente tiene pruebas, así que este paso se automatiza. Builder de calidad y alineación es un agente que escribe el catálogo de pruebas de otro agente. Elegís el agente a probar por nombre y, si querés, un foco. Lee lo que realmente está desplegado (la definición activa con sus pasos, prompts, guardrails, configuración de memoria, herramientas y el conocimiento que pueda leer) y deriva la cobertura que corresponde: caminos positivos y negativos, conversaciones de varios turnos, seguridad, grounding, uso de herramientas y efectos secundarios. Una capacidad que el agente no tiene no aplica, así que un agente sin base de conocimiento no recibe casos de grounding. El contenido que no puede leer se informa como una brecha, no se completa con hechos inventados.
Dos propiedades evitan que corrija su propia tarea.
La primera es estructural. El builder trabaja con una credencial que dura cinco minutos, cubre una sola organización, nunca lleva autoridad de administrador, y es un techo sobre los permisos de quien la pide, no una llave propia. Esa credencial puede crear y editar casos y publicar un conjunto congelado. Se le niega lanzar una ejecución, cancelarla, pedir una llamada al juez o registrar una revisión humana, y un test fija los casos de lanzar, cancelar y juzgar. El agente que escribe las pruebas no puede ser el que las ejecuta ni las califica.
La segunda es sobre lo que el builder puede afirmar. Su resumen final de lo que creó lo arma código a partir de lo que se volvió a leer del sistema, e ignora los identificadores y veredictos que escribió el propio modelo. Lo agregamos después de que nuestra revisión de aceptación detectara una versión anterior que producía un resumen fluido con identificadores inventados y una certificación que nadie había hecho, y, en otra corrida, un criterio aflojado en silencio para que un caso pasara. El criterio aflojado se restauró exactamente y el resultado fallido quedó en el registro.
Los casos pasan una verificación de coherencia antes y después de escribirse: un criterio determinista no puede rechazar una respuesta que la referencia del propio caso acepta. Los hechos, las recomendaciones y las negativas arrancan con una lista de criterios vacía más una referencia escrita para el juez, y una lista vacía nunca cuenta como aprobado. El resultado dice «solo medido» y el veredicto queda no evaluable hasta que un juez o una persona decida.
Congelar el conjunto de pruebas
Cada edición de un caso produce una revisión nueva con un hash de contenido. Publicar un plan de pruebas registra las revisiones exactas que contiene y un hash del conjunto completo. Las ediciones posteriores de un caso no cambian nada del plan de pruebas ni de las ejecuciones hechas con él. Para probar un cambio, publicás otro plan de pruebas.
Al lanzar una ejecución se escribe un manifiesto: el hash del plan de pruebas, el hash de la definición del agente probado y la versión que estaba activa, las versiones de los agentes de los que depende, los límites, y quién admitió la ejecución y cuándo. Quien la lanza tiene que reconocer que el agente puede tomar acciones reales, porque corre con sus herramientas reales.
Ejecución: un registro, no una nota
Cada caso corre tantas repeticiones como definas, hasta diez, con como máximo dos intentos en vuelo, y cada intento tiene su propia identidad de conversación y de memoria. Los casos de varios turnos avanzan turno por turno en una misma conversación. Cada turno registra la versión del agente que realmente respondió. Si difiere de la versión al momento de la admisión, el intento se marca como derivado (drifted) y se excluye de la comparación.
Los criterios deterministas cubren ocho tipos de chequeo: texto exacto, texto contenido, texto ausente, igualdad de JSON, una herramienta llamada, una herramienta no llamada, argumentos de herramienta y una fuente de conocimiento recuperada. Todo criterio es obligatorio, así que una falla nunca se promedia. La evidencia faltante, como una respuesta retenida por privacidad o una traza de herramientas incompleta, da no evaluable y no un aprobado. Una ejecución detenida cancela el trabajo futuro y pide frenar al trabajo activo, pero no deshace nada de lo ya hecho, y una acción interrumpida con resultado incierto nunca se repite automáticamente.
Juicio sobre evidencia guardada
Un evaluador es una revisión inmutable y con hash que nombra una conexión de modelo propia de tu organización. Volver a puntuar lee la evidencia ya almacenada y llama solo al juez. En nuestra corrida de aceptación en producción del 9 de noviembre de 2026, un agente de prueba respondió siete intentos en ocho turnos (8.784 tokens), el juez puntuó los siete, y los identificadores de las ejecuciones del agente fueron idénticos antes y después de juzgar.
Cada evaluación guarda los hashes del evaluador y de la evidencia, la versión del prompt, el modelo pedido y el modelo observado con su huella (fingerprint), y el uso de tokens con el costo rotulado como costo del evaluador, aparte del del agente. Cada pedido lleva su propio identificador, así que un reintento no puede gastar dos veces, y un resultado que sigue incierto se registra como error y nunca se vuelve a despachar.
Las revisiones humanas se agregan con la identidad y la hora de quien revisa. No pisan el resultado automático. Una vista de calibración empareja después los veredictos del juez con etiquetas humanas explícitas para una revisión de evaluador y reporta el acuerdo, con sus límites dichos: las etiquetas cubren un intento completo, y el acuerdo sobre etiquetas elegidas no es una estimación de exactitud.
Comparar versiones con condiciones registradas
Dos ejecuciones son compatibles solo si coinciden la configuración del agente probado, los límites, el hash del conjunto de datos y las condiciones de juicio. Todo lo demás es exploratorio, con las razones listadas. Dentro de un caso, los resultados se emparejan por repetición. Una regresión crítica sigue visible aunque el promedio mejore, los casos y la evidencia faltantes se listan en vez de salir del denominador, y las re-puntuaciones cuentan como observaciones separadas, no como repeticiones extra. La comparación declara que no hace atribución causal: si cambiás el agente, el conjunto de datos y el evaluador a la vez, dice que no puede decirte cuál de los tres importó.
Auditoría
Crear, editar o archivar un proyecto o un caso, publicar un plan de pruebas, lanzar o cancelar una ejecución, publicar un evaluador, registrar una evaluación del juez y registrar una revisión humana escriben cada uno una entrada atribuida al actor. Leídas junto con los manifiestos, responden la pregunta de auditoría de una sola pasada: quién escribió esta prueba, contra qué revisión, sobre qué versión del agente, juzgada por qué modelo bajo qué evaluador, a qué costo registrado. Todo queda dentro de una organización, que además asume el costo de la inferencia del propio builder. Un tenant o un plan puede apagar la capacidad, y cuando está apagada la creación manual sigue funcionando.
Para un cambio de modelo, la historia del failover es el mismo ciclo hecho a propósito: un candidato contra una línea base sobre un conjunto congelado. Para la revisión permanente de toda una flota, la revisión mensual de la flota es donde se leen estos resultados.
Límites
- Las versiones se observan, no se fijan. Una ejecución prueba la versión que esté activa cuando se la admite. La deriva durante la ejecución se detecta y se marca, no se impide.
- Nada lanza una ejecución por vos. Iniciarla es un acto explícito de una persona o de un llamador autorizado. Activar una versión nueva no dispara una ejecución automática, y nada bloquea una activación por un resultado fallido.
- El gasto no tiene un tope duro. Las llamadas al juez se controlan primero contra los límites de la organización, y las ejecuciones del agente cargan el costo real del agente real, pero la plataforma aclara que sus controles de gasto no son un techo distribuido.
- Algunas condiciones se desconocen. El estado del índice de conocimiento al momento de la ejecución y los precios históricos de los modelos no se capturan, y las comparaciones los listan como limitaciones.
- Los casos generados no son pruebas superadas. El builder deriva los casos de la definición, no de tu tráfico de producción. Los casos sacados de fallas reales los sumás vos, y son los mejores.
- El juez admite un conjunto acotado de proveedores. OpenAI, endpoints compatibles con OpenAI y DeepSeek, con salida estructurada, a través de una conexión propiedad de la organización.
Seis chequeos para cualquier sistema de pruebas
Con lo que sea que pruebes agentes, estos seis chequeos distinguen un proceso de un tablero.
| Chequeo | Cómo verificarlo |
|---|---|
| El conjunto de pruebas no puede cambiar bajo una ejecución terminada | Editá un caso después de una ejecución y confirmá que la ejecución vieja sigue mostrando el texto original y su hash |
| Cada resultado nombra la versión del agente que lo produjo | Elegí una respuesta y nombrá la versión exacta solo con el registro |
| La evidencia faltante nunca es un aprobado | Retené una traza y confirmá que el veredicto pasa a «no evaluable» |
| Volver a juzgar nunca vuelve a ejecutar el agente | Puntuá una ejecución dos veces y confirmá que los identificadores de ejecución del agente no cambiaron |
| Quien escribe las pruebas no puede ejecutarlas ni calificarlas | Intentá lanzar una ejecución con la credencial que escribió los casos |
| Una comparación dice cuándo no es comparable | Cambiá el modelo y el conjunto de datos a la vez y confirmá que la comparación dice que no puede atribuir la diferencia |