En un explainer publicado el 14 de octubre de 2026, Lari Hämäläinen, Wasim Lala y Kaavini Takkar, de McKinsey, describen un cambio que la mayoría de los operadores ya sintió. En el primer trimestre de 2026 los grandes proveedores de modelos pasaron de licencias por usuario a precios por consumo, y el mismo uso podía costar de la noche a la mañana entre dos y tres veces más. Llevar una herramienta de piloto a producción, cuentan, casi cuadruplica su gasto en promedio. La proyección de un banco pasó de unos tres millones de dólares al año a más de veinticinco millones cuando todos tuvieron acceso a todos los modelos sin ningún límite, y su respuesta fue pedir un único lugar donde se viera todo y se pudiera rastrear hasta una persona. Su conclusión es que el costo de la IA se puede medir y manejar, y que el control empieza por la visibilidad.
Visibilidad es la primera palabra correcta, pero no la última. Un número que podés leer después del hecho no frena un loop que corre toda la noche. Esta nota explica cómo AI Agent Builder controla el costo en cuatro lugares, cada uno a una distancia distinta del dinero: el tenant que paga, la ejecución que gasta, el modelo que usa cada paso y el registro que deja cada llamada. Cada uno frena algo que los otros no pueden, y la última sección dice qué no frena ninguno.
El tenant tiene la plata
La unidad que paga es el tenant: un cliente, una división, una filial. Cada tenant tiene su propia cuenta de gasto, en uno de tres modos. Un tenant prepago se atiende hasta que su saldo llega a cero. Uno pospago se atiende siempre y se le factura lo que usó. Uno ilimitado no se mide. Junto a la cuenta hay un tope mensual, de mensajes y de gasto, que el operador fija por tenant; un tope fijado en un padre vale para los tenants que cuelgan de él hasta que alguno fije el suyo.
Las dos cosas se leen antes de que corra cualquier paso de un turno. Cuando se agota un saldo prepago, o se alcanza un tope, el cliente lee una línea neutra que dice que el asistente no está disponible, sin una palabra sobre facturación, y no se llama a ningún modelo. Una denegación nunca se recuerda: en cuanto se recarga el saldo, el turno siguiente se atiende. Un tenant que trae su propia conexión con el proveedor queda fuera de la cuenta, porque la plataforma no cobra nada por una inferencia que el proveedor le factura directo; el tope mensual sigue valiendo.
El monto es el costo del proveedor por la llamada, pasado por un multiplicador o por un precio por modelo que fija el operador. Eso es lo que permite a una agencia revender inferencia con su propio margen. El saldo se debita una vez por ejecución, y el monto debitado es la suma de los montos registrados en las filas de esa ejecución, de modo que los dos cierran.
Esto responde a "qué cliente está gastando esto", y es deliberadamente grueso. Decide si un turno empieza. No puede saber cuánto va a costar un turno, así que necesita algo adentro del turno.
La ejecución tiene un cupo
Un solo turno de un agente que usa tools son muchas llamadas al modelo: una para decidir, una por cada resultado de tool, una para responder, más si reintenta. Los autores de McKinsey ponen la diferencia entre un agente bien diseñado y uno mal diseñado en hasta treinta veces más tokens para la misma tarea. El multiplicador que importa no es entonces el precio del token sino cuántas llamadas se le permite hacer a una ejecución, y por eso la aritmética de un turno cuenta llamadas y no mensajes.
Un agente puede llevar tres topes para una ejecución: una cantidad de llamadas al modelo, una cantidad de llamadas a tools y un monto de dinero gastado en inferencia. Cuentan sobre todos los pasos de la ejecución, no por nodo, y los dos que acotan llamadas al modelo también cuentan las llamadas de los agentes a los que delega, de modo que un subagente no puede gastar lo que a su agente padre le negaron.
El tope de dinero es el interesante, porque el costo de una llamada solo se conoce después de que vuelve. La plataforma no espera a enterarse:
- Antes de la llamada, reserva el peor caso. El peor caso de una llamada es la ventana de contexto completa del modelo usada para la entrada y otra vez para la salida, al precio de ese modelo. Si lo que ya se gastó más esa reserva supera el tope, la llamada se rechaza y nunca llega al proveedor.
- La reserva se anota primero. Se guarda de forma durable antes de enviar el pedido. Si no se puede guardar, la llamada no se hace.
- Cuando llega la respuesta, la reserva se reemplaza por el costo real, calculado con los tokens que informa el proveedor.
- Una llamada que falla conserva su reserva. Si el proveedor corta la conexión, nadie sabe qué se consumió, así que la ejecución queda retenida al peor caso. Un loop de reintentos no puede pasar el tope gastando a fuerza de fallar.
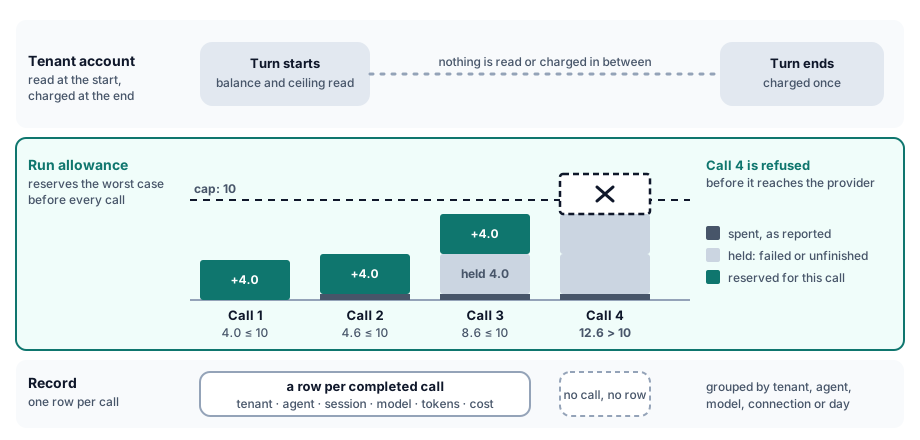
Una ejecución con tope de diez centavos, sobre un modelo cuyo peor caso para una llamada es de cuatro centavos, se comporta así:
| Evento | Contado contra el tope, en centavos |
|---|---|
| La llamada 1 reserva su peor caso | 4,0 |
| La llamada 1 vuelve; costó realmente 0,6 | 0,6 |
| La llamada 2 reserva su peor caso | 0,6 + 4,0 = 4,6 |
| La llamada 2 falla; su costo es desconocido | 4,6, sigue reteniendo los 4,0 |
| La llamada 3 reserva su peor caso | 4,6 + 4,0 = 8,6 |
| Se pide la llamada 4 | 8,6 + 4,0 = 12,6, más de 10: rechazada |
El rechazo es un error tipado que no se reintenta, y nombra lo que ya se completó para que las llamadas a tools terminadas no se repitan.
De guardar el cupo como un registro y no como un contador en memoria salen dos propiedades más. Sobrevive a una pausa: una ejecución que espera que una persona apruebe un paso vuelve con su gasto intacto, no reiniciado. Y rechaza lo que no puede medir: bajo un tope de dinero, un modelo cuyo precio la plataforma no conoce se rechaza antes de enviar ningún pedido, porque un tope sobre un costo que no podés calcular es un tope de nombre nomás.
Cada llamada deja un registro
Cada llamada al modelo se guarda como una fila propia: el tenant, el agente, la sesión, la conexión por la que pasó, el proveedor y el modelo, los tokens de entrada y de salida, cuántos eran cacheados, el costo estimado, lo facturado y bajo qué precio. El registro se escribe se facture o no la ejecución, así que una llamada es visible aunque a nadie se le cobre.
El reporte sobre esas filas agrupa por tenant, agente, modelo, conexión, día o categoría, filtra por cualquiera de ellos, se limita a lo que la persona que consulta puede ver y se exporta a una planilla. La pregunta que el banco del ejemplo de McKinsey quería hacerle a cada pedido, por qué no se enrutó a un modelo más barato, es un agrupamiento por modelo y conexión. "Qué agente lo gastó" y "qué cliente" están a un clic. Como la sesión está en cada fila, el costo de una conversación entera es la suma de sus filas.
Nada de esto cambia lo que hace un agente. Hace ajustables los otros tres lugares, que es para lo que sirve la visibilidad.
El modelo es parte de la definición
El token más barato es el que un paso determinístico nunca gasta. Un workflow que ya sabe su próximo movimiento no necesita un modelo que se lo diga: las condiciones, el código y las llamadas directas a tools corren como pasos comunes, y se gasta un modelo solo donde una decisión o una frase está realmente abierta.
Donde hace falta un modelo, cuál es una propiedad del agente y de su tenant, no de quien lo esté usando. El tenant asigna cada uno de unos pocos niveles de razonamiento, de bajo a alto, a una conexión y un modelo. Un agente pide un nivel, de modo que un operador que descubre que el nivel más alto se usa de más cambia qué significa una sola vez, para todos los agentes, en lugar de editarlos uno por uno. Un paso que necesita un modelo en particular puede nombrar una conexión y un modelo de forma explícita, y esa elección queda visible en la definición y no adentro de un prompt. Los autores de McKinsey describen el patrón opuesto: el uso en un cliente que pasó de un modelo de gama media al de gama más alta en pocos meses, porque el mejor modelo estaba disponible y la gente lo elegía. Un modelo escrito en la definición y visible en el reporte no se corre así sin que nadie se entere.
Las decisiones son el caso donde el ahorro es mayor. Clasificar un mensaje, chequear el alcance y elegir una tool los responde un modelo de decisión con un valor y una confianza en lugar de un párrafo generado, de modo que los pasos que corren en cada turno dejan de pagar una generación que nunca necesitaron.
Dónde se detiene
- Los topes son opcionales. Un agente sin límites no tiene ninguno. La plataforma pone el freno; quien arma el agente decide ponerlo.
- Los controles del tenant se leen antes del turno y se cobran después. Un saldo o un tope se chequea al empezar y se debita una sola vez al terminar, así que un turno en curso puede llevar un saldo por debajo de cero, y varios turnos que empiezan juntos leen la misma cifra y proceden todos. El cupo de la ejecución acota a cada uno, si está fijado. Nada acota la cantidad de ellos.
- Los controles del tenant fallan abiertos (fail open). Si la consulta misma falla, el turno se atiende y se registra el fallo. Es deliberado, porque una caída en la medición no debería dejar a los agentes fuera de servicio, y hace que estos límites sean un control de costo y no un límite de seguridad.
- Una ejecución fallida se registra y no se factura. Las llamadas están en el reporte, pero al tenant no se le cobra una ejecución que terminó en error, así que ese costo del proveedor recae en quien opera la plataforma.
- La reserva es conservadora. Un tope menor que una llamada en el peor caso rechaza la primera llamada aunque hubiera costado una fracción. Los topes funcionan mejor unas cuantas veces por encima de una ejecución típica.
- La estimación no descuenta el caché. La cantidad de tokens cacheados se registra, pero el costo estimado se calcula solo con tokens de entrada y de salida, así que donde un proveedor descuenta la entrada cacheada la estimación es un máximo.
- Mide el costo del modelo, no el resto del costo. En un análisis aparte sobre la economía de los agentes publicado el 24 de agosto de 2026, McKinsey encuentra que en un agente de atención al cliente de un banco los tokens son entre el 20 y el 25 por ciento del costo variable de una ejecución y la supervisión humana entre el 70 y el 75 por ciento. La plataforma ve los tokens. El tiempo que una persona dedica a revisar una respuesta queda afuera, y también el costo de un caso resuelto.
Invariantes para probar en cualquier sistema
Sobre lo que sea que corran tus agentes, seis chequeos dicen si sus controles de costo son controles o son reportes.
| Invariante | Cómo probarla |
|---|---|
| Un tope frena el gasto, no solo lo informa | Fijá un tope de una llamada, disparás una segunda y mirás del lado del proveedor si llegó un pedido que nunca debió llegar |
| Un fallo no es gratis | Hacé que el proveedor corte una llamada a mitad de camino y confirmá que el presupuesto de la ejecución no se devolvió |
| El costo desconocido falla cerrado | Apuntá un agente con tope a un modelo sin precio conocido y confirmá que se rechaza antes de enviar |
| El trabajo delegado comparte el cupo | Hacé que un agente le pase trabajo a otro y confirmá que el segundo consume del tope del primero |
| El cupo sobrevive a una pausa | Detené una ejecución para aprobación, retomala y confirmá que lo gastado sigue contado |
| Cada llamada es atribuible | Elegí una llamada y nombrá su cliente, su agente y su modelo solo con el registro |
Un sistema que falla la primera o la segunda tiene un dashboard. Uno que falla la última tiene un número que no puede explicar.